Por Andrew Tan
La demo que nunca envejece
Así es como suele ir el argumento de venta de Iceberg:
Un ingeniero se para delante de una pantalla y ejecuta una consulta contra un conjunto de datos en Parquet. Luego ejecuta la misma consulta contra una tabla de Iceberg. Los resultados son idénticos. El público asiente. Entonces el ingeniero muestra el viaje en el tiempo —volver a una instantánea anterior— y la sala realmente murmura. Alguien pregunta por la evolución del esquema. El ingeniero añade una columna, no reescribe nada y las consultas antiguas siguen funcionando. El comité está convencido.
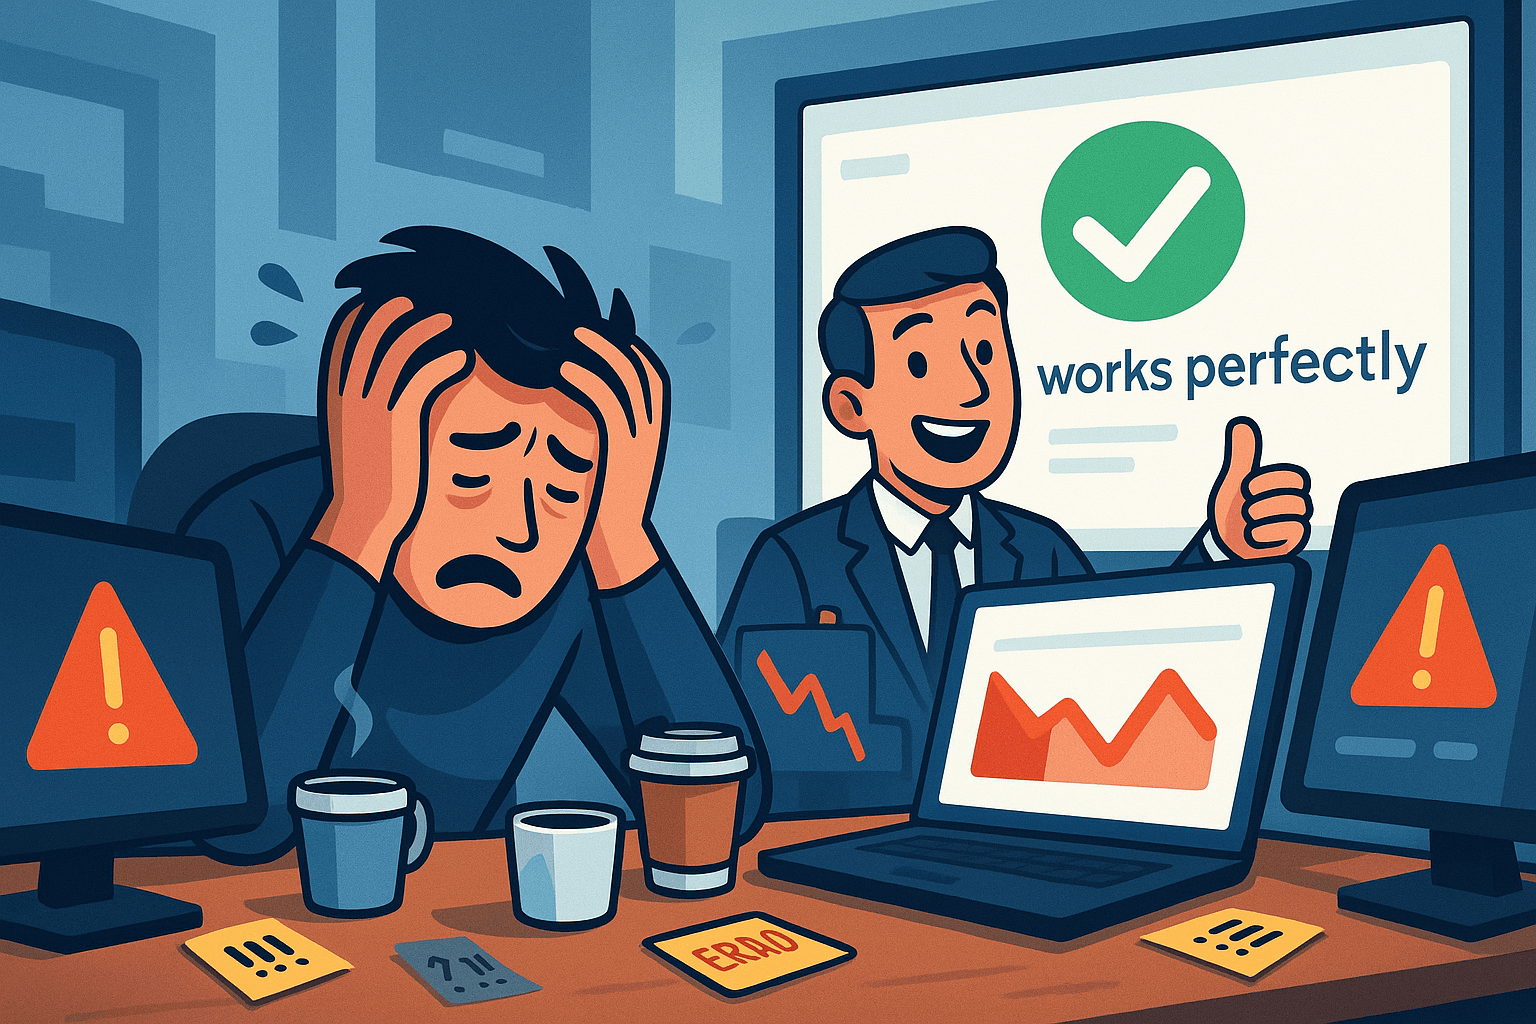
Seis meses después, el mismo equipo está en otra sala. Esta no tiene pantalla. Solo una hoja de cálculo, una lista creciente de alertas y una pregunta que nadie hizo durante la demo:
¿Quién es el dueño de la compactación?
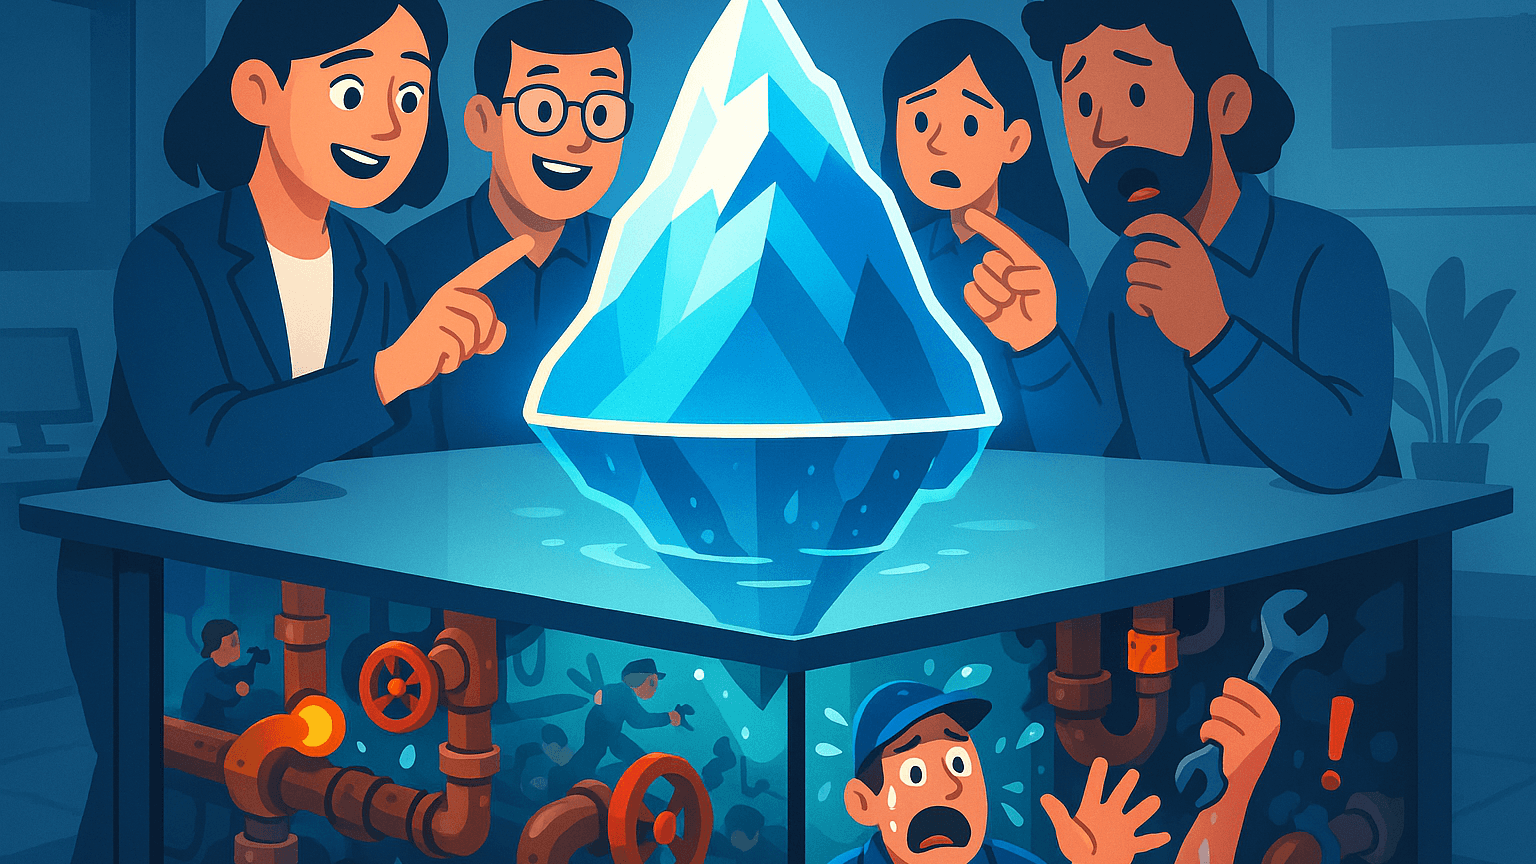
La demo mostró lo que Iceberg hace posible. No mostró lo que Iceberg convierte en tu problema.
Lo que promete la especificación frente a lo que hereda el equipo
Los formatos de tabla abiertos son un avance genuino. La portabilidad entre motores, el aislamiento de instantáneas, la evolución de particiones y el particionamiento oculto son capacidades reales que resuelven dolores reales. Si estás intentando escapar de un almacén de datos bloqueado por un proveedor, Iceberg, Delta Lake y Hudi son las mejores salidas.
Pero la especificación no es el sistema. La especificación dice cómo se debe organizar la metadata. No dice cómo tu equipo debe evitar que esa metadata crezca sin límite, cómo coordinar la compactación entre múltiples escritores o qué ocurre cuando dos motores de consulta distintos no se ponen de acuerdo sobre qué instantánea leer.
Esto es lo que la demo omite:
La compactación no es automática
Cada inserción, actualización y eliminación crea archivos nuevos y entradas nuevas de metadata. Si se deja sola, una tabla de alta velocidad acumula miles de archivos pequeños. El rendimiento de las consultas se degrada. Los archivos de metadata crecen. La tabla que parecía rápida en la demo empieza a dar tiempos de espera en producción. Alguien tiene que programar la compactación, supervisarla, ajustarla y gestionar los fallos cuando dos trabajos intentan reescribir la misma partición.
La proliferación de catálogos es real
Las tablas de Iceberg necesitan un catálogo: Hive, Glue, Nessie, Polaris, un servicio REST personalizado. Cada catálogo tiene su propio modelo de consistencia, su propia autenticación, su propio ciclo de actualizaciones. Un equipo que adopta Iceberg para evitar el bloqueo del proveedor a menudo termina gestionando dos o tres sistemas de catálogo en lugar de un solo almacén. El bloqueo se traslada del formato de almacenamiento a la capa de catálogo.
La política de retención es un problema distribuido
Cuando una instantánea expira, Iceberg marca los datos como inaccesibles. Pero los archivos subyacentes siguen existiendo en el almacenamiento de objetos hasta que algo los elimina. Ese "algo" es tu problema. Si configuras una retención agresiva para ahorrar en almacenamiento, puedes perder la capacidad de revertir cuando un trabajo aguas abajo genera malos resultados. Si guardas todo, tu factura de almacenamiento se acumula mientras tu bucket de S3 se convierte en una excavación arqueológica.
Los procesos por lotes y en streaming ven tablas distintas
Un trabajo por lotes que escribe en Iceberg produce archivos grandes y bien estructurados. Un trabajo en streaming produce archivos pequeños y frecuentes. Si ambas rutas escriben en la misma tabla, el planificador de consultas tiene que manejar dos diseños de archivo radicalmente diferentes. La ruta en streaming necesita una compactación frecuente para seguir siendo legible. La ruta por lotes necesita archivos estables para evitar recomputaciones. Coordinar estos dos ritmos en una sola tabla es más difícil de lo que sugieren los diagramas de arquitectura.
La demo mostró un solo escritor y un solo lector. La producción rara vez funciona así.
Por qué "abierto" crea una nueva fragmentación
La promesa de los formatos de tabla abiertos es la interoperabilidad. Consulta los mismos datos desde Spark, Trino, Flink, DuckDB, Snowflake, BigQuery. En la práctica, cada motor soporta un subconjunto distinto de la especificación con un nivel de madurez distinto.
Un motor soporta eliminaciones por posición pero no eliminaciones por igualdad. Otro soporta el viaje en el tiempo, pero solo para tablas escritas por su propio catálogo. Un tercero soporta la evolución de particiones, pero requiere una versión específica de metadata que rompe lectores más antiguos. La tabla es "abierta" en teoría. En la práctica, está acoplada a la combinación específica de motores y versiones de catálogo que tu equipo ejecuta.
Esto no es una crítica a los proyectos en sí. Iceberg, Delta y Hudi avanzan rápido y mejoran constantemente. El problema es que los equipos los adoptan esperando liberación y descubren una nueva superficie operativa. En lugar de un proveedor al que culpar, tienen una matriz de compatibilidades de versiones que gestionar.
El coste oculto es la carga cognitiva. Tus ingenieros de datos ahora necesitan entender no solo sus pipelines, sino también la programación de compactación, el modelo de consistencia del catálogo, la versión del formato de metadata y los comportamientos específicos de cada motor que toca la tabla. Esa experiencia no se adquiere en una demo.
La lista de verificación que nadie hace antes de adoptar
Si tu equipo está evaluando un formato de tabla abierto, estas son las preguntas que importan más que el rendimiento de las consultas en un benchmark:
¿Quién es el dueño de la compactación y qué ocurre cuando falla?
La compactación no es una configuración única. Es un proceso continuo en segundo plano que compite por los mismos recursos de cómputo que tus consultas de producción. Si la compactación se retrasa, las consultas se ralentizan. Si la compactación corrompe una partición, la recuperación es manual y estresante. Necesitas un dueño, un runbook y una forma de detectar cuándo la compactación no está al día.
¿Cuál es tu estrategia de salida del catálogo?
Los catálogos son el verdadero punto de bloqueo. Si te comprometes con Glue hoy, ¿puedes migrar a Nessie o Polaris más tarde sin reescribir las rutas de las tablas y reconfigurar cada trabajo aguas abajo? La mayoría de los equipos no prueba esto hasta que se ven obligados.
¿Cómo gestionas los datos tardíos y las backfills?
Las backfills por lotes y las llegadas tardías en streaming reescriben particiones históricas. Los formatos de tabla abiertos gestionan esto mejor que Parquet en bruto, pero no eliminan el problema de coordinación. Si una backfill se ejecuta mientras un trabajo en streaming añade datos a la misma partición, necesitas entender la semántica de aislamiento, el comportamiento de reintentos y exactamente qué hace cada motor cuando ve un conflicto.
¿Cuál es tu plan de crecimiento de metadata?
Los archivos de metadata son pequeños, pero se multiplican. Una tabla con instantáneas diarias y compactación horaria puede generar miles de archivos de metadata al mes. El almacenamiento de objetos es barato, pero las operaciones LIST no son gratuitas. Algunos motores de consulta cargan todo el árbol de metadata en memoria. A cierta escala, la metadata misma se convierte en un cuello de botella de rendimiento.
¿A quién se le avisa cuando una consulta devuelve resultados incorrectos?
El aislamiento de instantáneas es genial hasta que alguien lee la instantánea equivocada porque el catálogo fue brevemente inconsistente. O porque un trabajo en streaming confirmó un lote incompleto. O porque dos motores interpretaron el mismo archivo de metadata de forma distinta. Depurar estos problemas requiere experiencia en el formato, el catálogo y el motor específico. La guardia de guardias acaba de volverse más profunda.
Si no puedes responder estas preguntas con algo más específico que "ya lo veremos", no estás adoptando una tecnología. Estás asumiendo un nuevo dominio operativo.
Cuándo merece la pena el compromiso
Quiero ser justo. Hay situaciones en las que los formatos de tabla abiertos son claramente la elección correcta:
Estás escapando activamente del bloqueo del proveedor.
Si tu proveedor de almacén de datos está subiendo precios, deprecando funciones o limitando el tráfico de salida, la portabilidad de un formato abierto merece el coste operativo. La alternativa es quedarse atrapado.
Realmente necesitas viaje en el tiempo y rollback.
Algunas cargas de trabajo —especialmente en industrias reguladas o servicios financieros— requieren la capacidad de reconstruir el estado histórico exactamente. El modelo de instantáneas no es un lujo aquí. Es un requisito de cumplimiento.
Ejecutas varios motores de cómputo sobre los mismos datos.
Si tu equipo de análisis usa Spark, tu equipo de BI usa Trino y tu pipeline de ML usa DuckDB, un formato de tabla abierto compartido elimina el baile de extract-transform-load entre sistemas. El coste de coordinación es real, pero es menor que mantener tres copias separadas del mismo conjunto de datos.
Tienes el equipo para ello.
Si tienes ingenieros que entienden formatos de metadata, estrategias de compactación y modelos de consistencia de catálogos, la carga operativa es manejable. Si no, estás externalizando la experiencia a consultores y esperando que sigan disponibles.
Dónde encaja layline.io
En layline.io, no vendemos un formato de tabla. Vendemos un runtime de procesamiento que gestiona cargas de trabajo tanto por lotes como en streaming sobre la infraestructura que ya tienes. Eso incluye formatos de tabla abiertos cuando tienen sentido, y almacenamiento tradicional cuando no.
La razón por la que esto importa: muchos equipos adoptan Iceberg porque necesitan que el procesamiento por lotes y en streaming coexisten, y les han dicho que los formatos de tabla abiertos son la única forma de unificarlos. Eso no es cierto. La unificación ocurre en la capa de procesamiento, no en la capa de almacenamiento. Si tu runtime puede escribir archivos bien estructurados en modo por lotes y gestionar micro-lotes en modo streaming —mientras administra compactación, backfills y datos tardíos en el mismo flujo de trabajo—, el formato de almacenamiento se convierte en una elección de configuración, no en un compromiso arquitectónico.
Vemos equipos que adoptaron Iceberg por las razones correctas y luego descubrieron que la parte difícil nunca fue el formato. Era la coordinación operativa a su alrededor: mantener consistentes las rutas por lotes y en streaming, gestionar cambios de esquema sin romper consumidores aguas abajo y asegurarse de que la misma lógica de negocio produzca los mismos resultados independientemente de cuándo lleguen los datos.
Ese es el problema en el que nos enfocamos. El formato de tabla es un detalle. El modelo operativo es lo que determina si el sistema funciona a las 2 AM de un martes.
La pregunta que hay que hacer antes de la demo
La próxima vez que un proveedor te muestre una demo brillante de Iceberg —viaje en el tiempo, evolución de particiones, cambio de motor que parece no requerir esfuerzo— pregúntales esto:
"Muéstrame el calendario de compactación. Muéstrame el failover del catálogo. Muéstrame qué ocurre cuando un trabajo en streaming y una backfill por lotes impactan la misma partición. Muéstrame la factura de almacenamiento después de seis meses de crecimiento de metadata. Y muéstrame a quién se le avisa cuando un motor de consulta lee una instantánea que fue parcialmente escrita."
Si la respuesta es una referencia a la documentación, estás viendo la parte fácil. La parte difícil es lo que tú vas a poseer durante los próximos tres años.
Los formatos de tabla abiertos no son una estafa. Son una tecnología real y valiosa con un coste operativo genuino que el marketing rara vez menciona. Los equipos que triunfan son los que cotizan ese coste de antemano, asignan la propiedad antes de crear la primera tabla y tratan el formato como un componente de un sistema operativo más grande —no como una capa mágica que hace desaparecer los problemas de infraestructura.
La demo es el principio. La factura de mantenimiento es donde realmente empieza la historia.
Si tu equipo está sopesando formatos de tabla abiertos y tratando de entender el coste total de propiedad, ponte en contacto. Trabajamos con equipos exactamente en este problema —y la realidad operativa suele ser más manejable que el miedo, una vez que sabes qué planificar.
Andrew Tan es un emprendedor en serie y fundador de layline.io, construyendo infraestructura de procesamiento de datos empresariales que gestiona cargas de trabajo tanto por lotes como en tiempo real a escala.