Todas las funciones que necesita. Nada que no hagas.
Desde flujos de trabajo visuales hasta formatos de datos exóticos e implementación de nivel de operador: layline.io brinda a los equipos de ingeniería las herramientas para crear canales de datos en tiempo real sin sobrecarga.
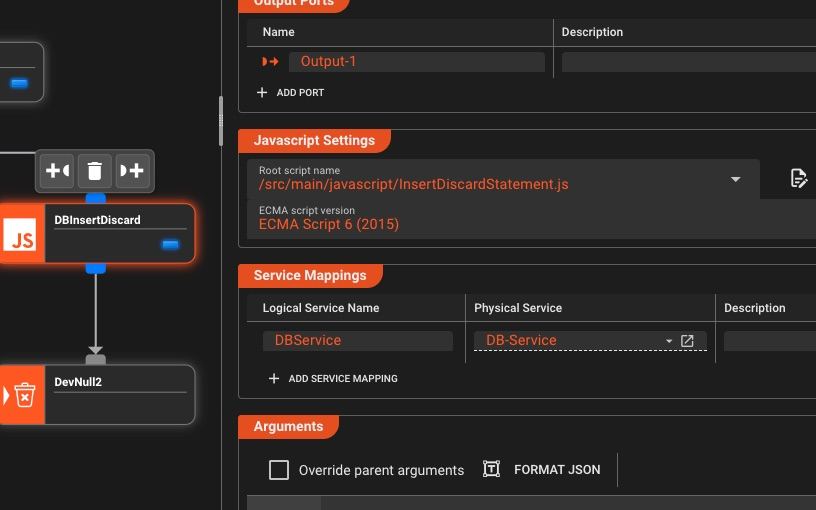
Construido para Tuberías del mundo real
Todo lo que necesita para crear, implementar y monitorear canales de datos de nivel de producción
Desarrollo de flujo de trabajo visual
Cree tuberías complejas con la simplicidad de arrastrar y soltar
Lienzo intuitivo de arrastrar y soltar
Cree flujos de trabajo visualmente conectando procesadores: acelere el desarrollo con una configuración sin código, utilice scripts personalizados cuando sea necesario
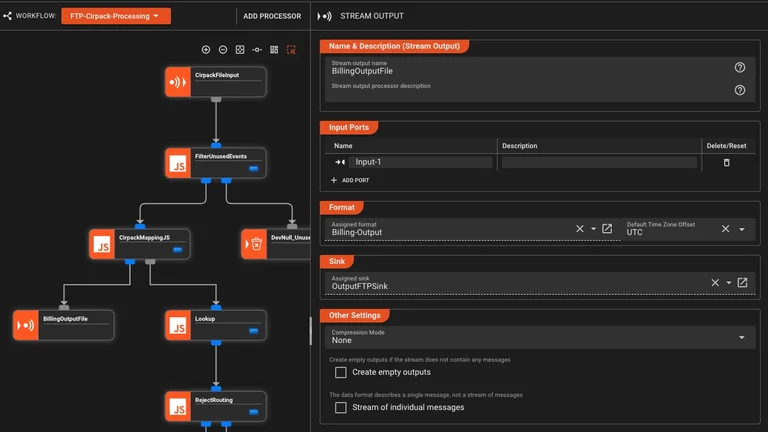
Validación en tiempo real
Detecte errores de configuración a medida que construye, antes de la implementación
- Comprobación de sintaxis instantánea
- Validación de esquema
- Detección de dependencia
- Error al resaltar
Control de versiones listo
Configuraciones almacenadas como JSON y scripts: seguimiento de cambios, bifurcación y fusión con cualquier sistema de control de versiones.
Assets reutilizables
Cree componentes modulares y reutilizables que se puedan utilizar como procesadores o a los que otros procesadores puedan hacer referencia: constrúyalos una vez y utilícelos en todas partes.
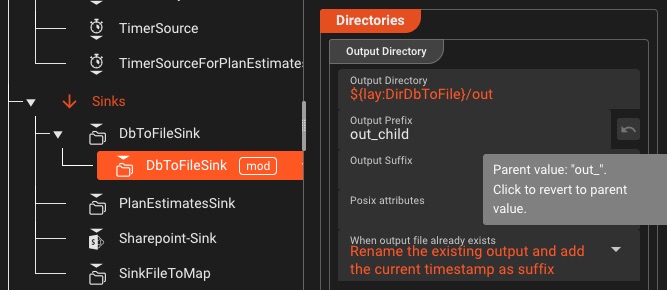
- Herencia de Asset para un fácil mantenimiento
- Derivar Assets unos de otros
- Compartido entre flujos de trabajo y proyectos
Plantillas personalizadas
Cree sus propias plantillas de flujo de trabajo y compártalas entre proyectos y equipos.
- Guarde flujos de trabajo como plantillas reutilizables
- Compartir entre proyectos y equipos
- Exportar proyectos completos o partes para su reutilización
Cree una vez e implemente en todas partes: en entornos y equipos
Depuración adjunta al navegador
Adjunte el depurador de su navegador al código Python o JavaScript y utilice todo el poder de las herramientas de desarrollo modernas.
- Ejecución paso a paso y puntos de interrupción condicionales
- Observe expresiones, ámbitos y pilas de llamadas
- Inspección de mensajes en cada etapa con variables en vivo.
- Seguimientos de pila de errores con mapeo de origen
Búsqueda y navegación del flujo de trabajo
Encuentre y navegue rápidamente a través de procesadores, configuraciones, elementos de flujo de trabajo y scripts
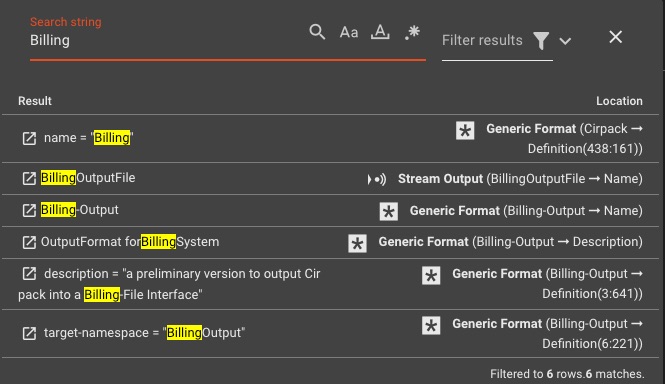
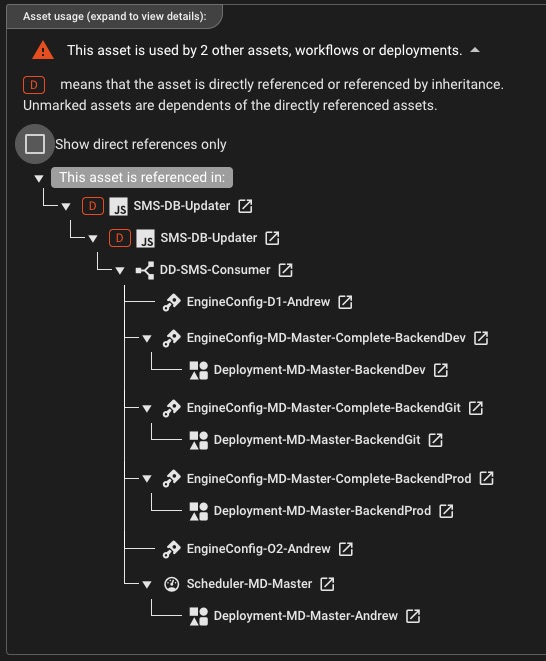
Visualización de dependencia de Asset
Comprenda cómo se conectan los Assets, los flujos de trabajo y las implementaciones a lo largo de su proyecto
Colaboración en equipo
Comparta flujos de trabajo y colabore con control de acceso basado en roles
- Control de acceso granular
- Edición simultánea de proyectos
- Notificaciones de cambios de proyecto
Conectividad de datos universal
Soporte de protocolo universal para cualquier origen y destino de datos.
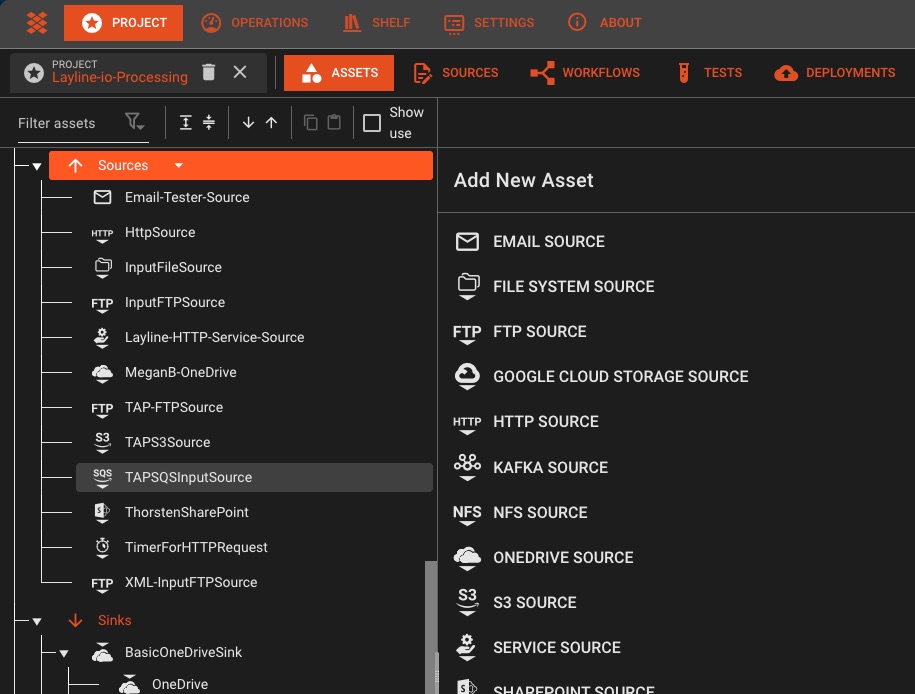
Plataformas de transmisión
Kafka, AWS SQS y SNS, UDP, Azure Event Hubs y más, todo con soporte nativo.
- • Grupos de consumidores
- • Semántica exactamente una vez
- • Procesamiento por lotes
- • Flujos de datos de Kinesis
- • Mensajes SQS y SNS
- • S3 notificaciones de eventos
Conectores de bases de datos
Lea y escriba en cualquier base de datos con soporte de captura de datos modificados.
- PostgreSQL, MySQL, SQL Server
- MongoDB, Cassandra, Redis
- Elasticsearch, DynamoDB
- AWS Keyspaces
- Hazelcast
- GCS
- Sharepoint
- más...
Change Data Capture
Debezium Source Asset integrado para pipelines CDC confiables y observables
- CDC basado en Debezium
- Manejo nativo de backpressure y retry unificado
- Diseño visual de pipelines con CDC como ciudadano de primera clase
REST APIs y webhooks
Llame a cualquier punto final HTTP con reintento, interrupción de circuito y autenticación integrados
- OAuth 2.0, API teclas, JWT
- GraphQL consultas
Servicios nativos de la nube
Integración profunda con AWS, Azure y Google Cloud
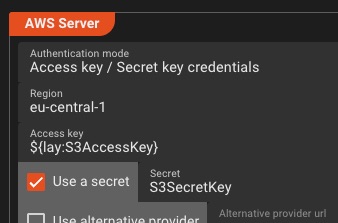
- S3, Azure Blob, GCS
- SNS/SQS, Service Bus
- CloudWatch & App Insights
- IAM e identidades administradas
Enterprise Compartir archivos
Acceda a archivos compartidos corporativos y repositorios de documentos en la nube
- SMB/CIFS recursos compartidos de red
- NFS (Sistema de archivos de red)
- WebDAV soporte de protocolo
- Abstracción del sistema de archivos virtual
Microsoft 365 Integración
Integración profunda con SharePoint, OneDrive y Microsoft Graph API para la colaboración empresarial
Protocolos de red
Acceso a la red de bajo nivel para protocolos personalizados y transmisión de datos en tiempo real
- TCP/UDP soporte de fuente y receptor
- Manejo de enchufes sin procesar
- Implementación de protocolo personalizado
- Transmisión de datos binarios
Integración de correo electrónico
Active flujos de trabajo desde correos electrónicos y envíe notificaciones con archivos adjuntos
- IMAP/POP3 fuentes de correo electrónico
- SMTP entrega de correo electrónico
- Procesamiento de archivos adjuntos
- Monitoreo de múltiples buzones
Temporizador y fuentes programadas
Active flujos de trabajo en horarios, ventanas de tiempo o intervalos recurrentes para el procesamiento por lotes y tareas periódicas.
Patrones de programación complejos con soporte completo para cron
Activación sencilla basada en intervalos, desde segundos hasta meses
Definir ventanas de tiempo específicas para el procesamiento por lotes
Sistemas de archivos y protocolos heredados
Procese archivos desde unidades locales, recursos compartidos de red, servidores FTP/SFTP o almacenamiento en la nube, con sondeo automático, coincidencia de patrones y movimiento después del procesamiento.
Formatos de datos y análisis
Analice cualquier formato desde JSON hasta protocolos de telecomunicaciones heredados
Formatos estándar
Soporte nativo para los formatos de datos que ya utilizas
- ASN.1
- XML
- CSV, TSV, archivos delimitados
- Cualquier formato estructurado ASCII, binario o mixto
- Registros de ancho fijo
Configuración de formato universal
Defina cualquier formato de datos personalizado (CSV, ASCII jerárquico, binario o estructuras mixtas) con un potente lenguaje de configuración basado en gramática.
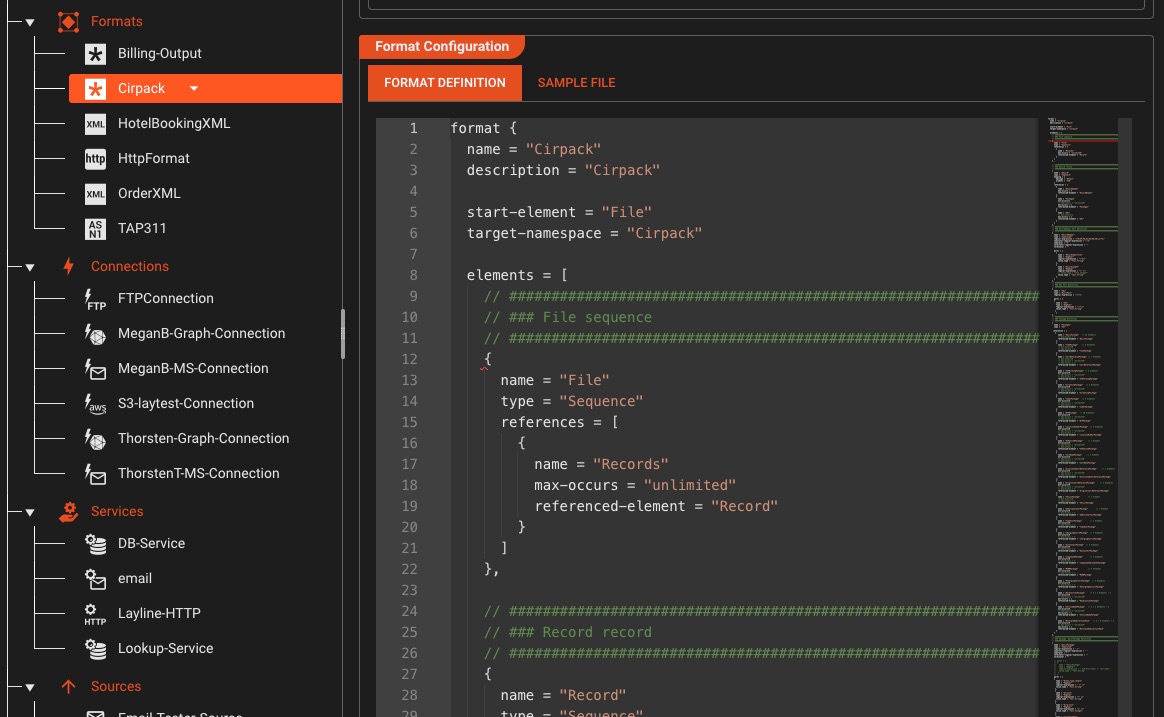
Definir formatos usando expresiones regulares y estructuras jerárquicas.
Cargue archivos de muestra y pruebe su gramática en tiempo real
Utilice la misma gramática tanto para analizar la entrada como para generar la salida.
Validación de sintaxis en tiempo real y resaltado de errores en el editor
ASN.1 y protocolos de telecomunicaciones
Capacidad únicaAnálisis ASN.1 líder en la industria para telecomunicaciones CDRs, SS7, TCAP, MAP y protocolos heredados: capacidades que no encontrará en las herramientas genéricas ETL.
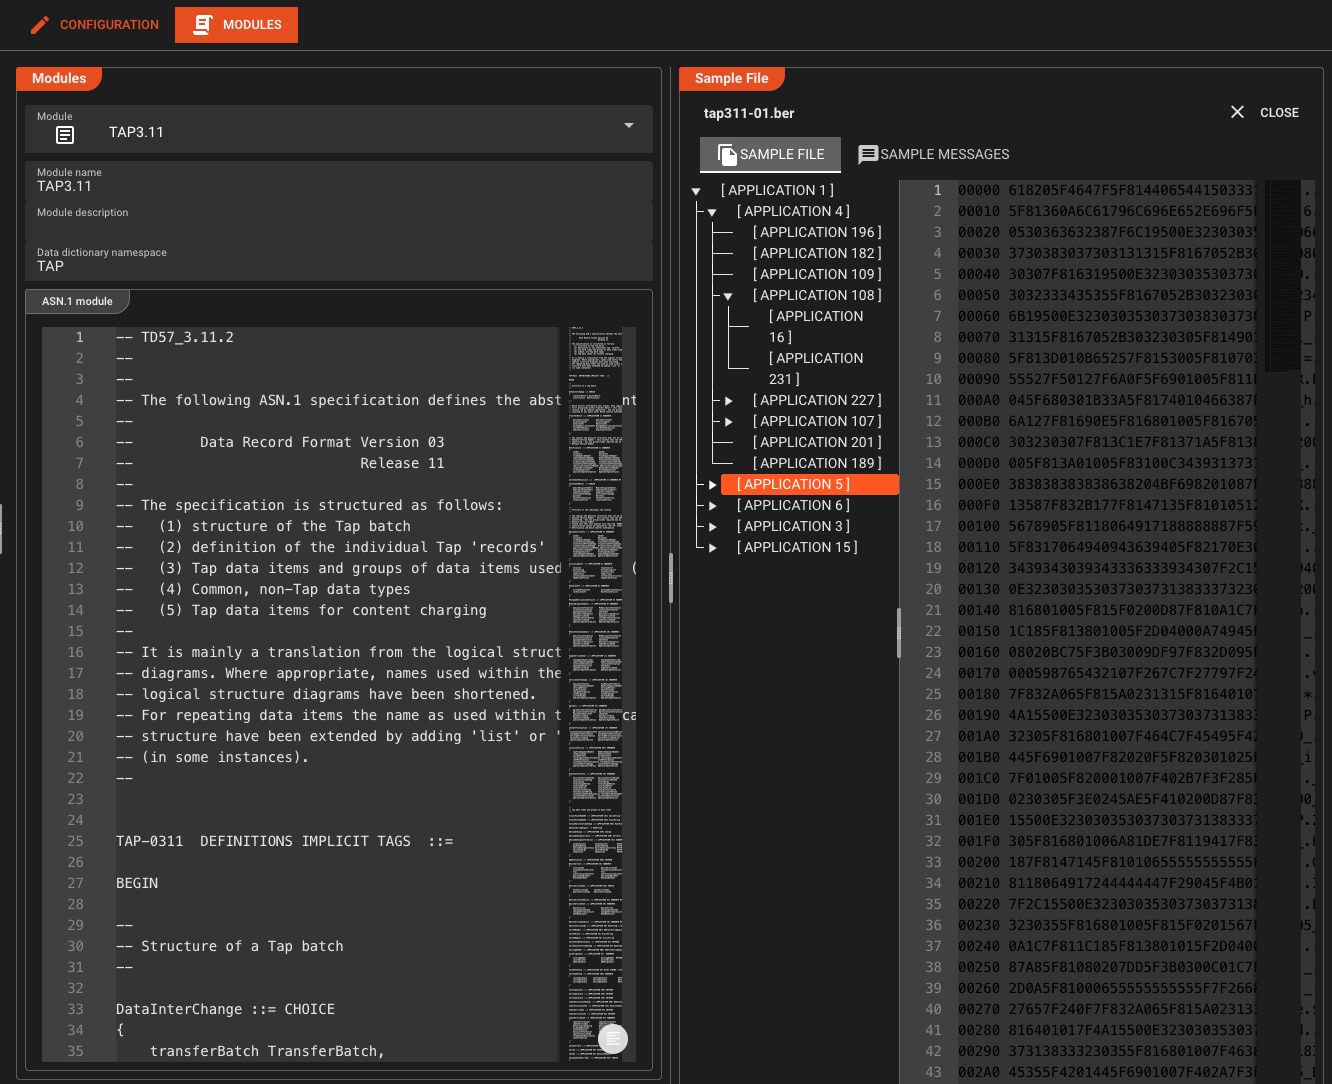
Estándares admitidos
Caso de uso: Procese miles de millones de CDRs de telecomunicaciones diariamente con un análisis de menos de un milisegundo
Data Dictionary
Tipo de sistemaDefina estructuras y tipos de datos personalizados que se pueden reutilizar en sus flujos de trabajo, con soporte completo para codificar/decodificar en formatos externos como JSON
Tipos personalizados
Definir secuencias, matrices, enumeraciones, opciones y espacios de nombres
Tipo Reutilización
Tipos de referencia en todos los formatos y flujos de trabajo para lograr coherencia
Aumento de mensajes
Agregue datos derivados o enriquecidos a mensajes en tiempo de ejecución
Integración de formatos
Tipos de referencia de cualquier formato: genérico, ASN.1 u otros Data Dictionaries
Transformación de formato
Aplicar transformaciones para convertir entre cualquier formato.
- Mapeo y reestructuración de campos
- Conversiones de tipos de datos
Formatos binarios personalizados
Defina sus propios analizadores de estructuras binarias con precisión
- Extracción de campos a nivel de bits
- Estructuras anidadas
- análisis condicional
Validación y calidad
Detecte datos con formato incorrecto antes de que corrompan su canalización
- Validación de esquema
- Reglas de validación personalizadas
- Enriquecimiento de errores
Procesamiento de formato nativo
Cambiador de juegoA diferencia de las herramientas tradicionales ETL que le obligan a asignar formatos externos a esquemas internos fijos y viceversa, layline.io trabaja directamente con sus datos en su formato nativo, eliminando gastos de transformación innecesarios.
Sistemas ETL Tradicionales
- •Asignar formato externo a esquema interno fijo en lectura
- •Procesar datos en representación interna genérica.
- •Asigne el esquema interno al formato de destino al escribir
- •Doble transformación y complejidad
layline.io Aproximación
- Analizar datos directamente en la estructura de formato nativo
- Trabajar con datos en su estructura original en todo momento.
- Data Dictionary creado dinámicamente a partir de sus formatos.
- Amplíe con estructuras personalizadas según sea necesario, sin mapeo
Por qué esto importa
Lógica empresarial y transformación
Incorpore lógica personalizada para enriquecimiento, enrutamiento y transformaciones complejas
Manejo de errores y reintento
Maneje las fallas con elegancia con políticas de reintento configurables y colas de mensajes fallidos
- Políticas de reintento configurables
- Estrategias de retroceso exponencial
- Enrutamiento de colas de mensajes fallidos
- Patrones de disyuntores
- Categorización de errores
JavaScript y Python Secuencias de comandos
Incorpore código personalizado directamente en sus flujos de trabajo: soporte completo de idiomas, no zona de pruebas limitada
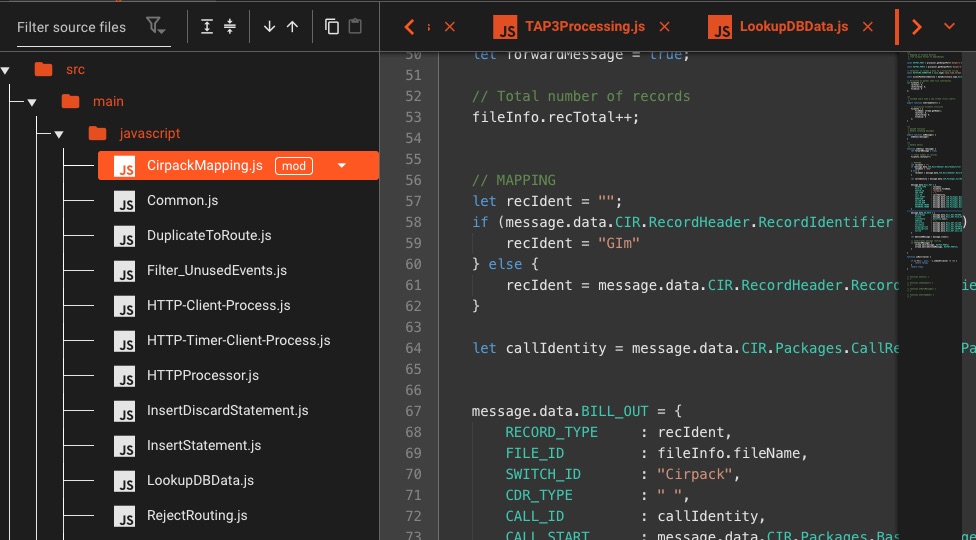
💡 También puedes usar tu IDE favorito para fines de secuencias de comandos
- Soporte asíncrono/en espera
- Importación/Exportaciones
- Ganchos del ciclo de vida
- Utilice Javascript/Python indistintamente
Mapeo de campo
Transforme y asigne campos de datos entre diferentes formatos y esquemas.
- Mapeador de campo visual
- Acceso a campos anidados
- Mapeos condicionales
- Tipo coerción
- Manejo de valores predeterminados
Enriquecimiento de datos
Aumente los eventos con datos externos de APIs, bases de datos o cachés
- Acceda a fuentes de servicios en cualquier lugar dentro del proceso
Enrutamiento y filtrado
Defina sus propias reglas con condiciones individuales: un procesador muy flexible adecuado para la mayoría, si no todos, los casos de enrutamiento y filtrado. Si esto no es suficiente, siempre puedes recurrir a scripts.
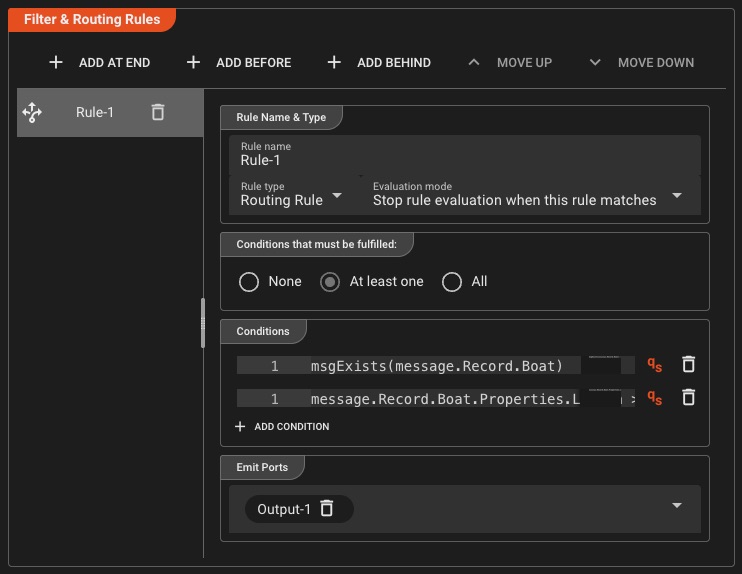
Enrutamiento basado en reglas
- Definir múltiples condiciones por regla
- Enrutamiento multidireccional a diferentes puertos
- Combinaciones de condiciones Y/O
Filtrado flexible
- Reglas de filtrado basadas en contenido
- Comparaciones de valores de campo
- Recurrir a secuencias de comandos cuando sea necesario
Limitación y estrangulamiento de velocidad
Controle el flujo de mensajes y evite la sobrecarga del sistema con regulación inteligente
- Control de tasa de mensajes
- Manejo de backpressure
- Gestión de ráfagas
- Aceleración dinámica
Procesamiento con estado
Mantenga el estado en todos los eventos para flujos de trabajo complejos
- Almacenes de estado en memoria
- Backends de estado persistente
- Garantías exactamente una vez
- Puntos de control y recuperación
- Seguridad transaccional
Realice un seguimiento de las sesiones de los usuarios, cuente eventos o mantenga totales acumulados en millones de transmisiones
Agregación y ventanas de tiempo
Flujos de procesos con ventanas giratorias, deslizantes o de sesión para análisis en tiempo real
Ventanas cayendo
Periodos de tiempo de tamaño fijo y que no se superponen
Cada 5 minutosVentanas corredizas
Ventanas superpuestas para medias móviles
Ventana de 10min, diapositiva de 1minVentanas de sesión
Agrupación basada en actividades con tiempo de espera
Brecha de inactividad de 30 segundos.Flexibilidad ilimitada
Usando JavaScript o Python, puede definir cualquier tipo de lógica de procesamiento basada en los mensajes que fluyen a través de sus procesadores. Encadene uno o varios procesadores para implementar sistemas completos: detección de fraude, cálculo de precios, filtrado, transformación o cualquier otra cosa que se le ocurra. Enriquezca los datos de fuentes externas, bifurque y enrute a destinos específicos según su lógica empresarial. Incluso puedes usar tu propio IDE en lugar de depender del Configuration Center para escribir tus scripts.
Detección de fraude
Analice patrones de transacciones en tiempo real para identificar y bloquear actividades fraudulentas
Precios dinámicos
Calcule precios sobre la marcha en función de la demanda, el inventario y las condiciones del mercado.
Transformación de datos
Filtre, remodele y enriquezca datos de múltiples fuentes en formatos unificados
Análisis en tiempo real
Agregue y calcule métricas a través de datos de transmisión para obtener información instantánea
Alertas inteligentes
Detecte anomalías y active notificaciones basadas en reglas comerciales personalizadas
Orquestación de eventos
Coordine flujos de trabajo complejos de varios pasos en sistemas distribuidos
Estos son sólo ejemplos. El sistema no se limita a estos casos de uso: implemente cualquier cosa que su empresa requiera con soporte completo para lenguajes de programación y enlaces de ciclo de vida para transmisiones, transacciones y mensajes.
Implementación y orquestación
Implemente en cualquier lugar: en la nube, en el perímetro o localmente con actualizaciones sin tiempo de inactividad
Implementación de clústeres con un solo clic
Implemente en cualquier clúster con un solo clic: sin línea de comando, sin configuraciones complejas, solo administración de implementación visual intuitiva
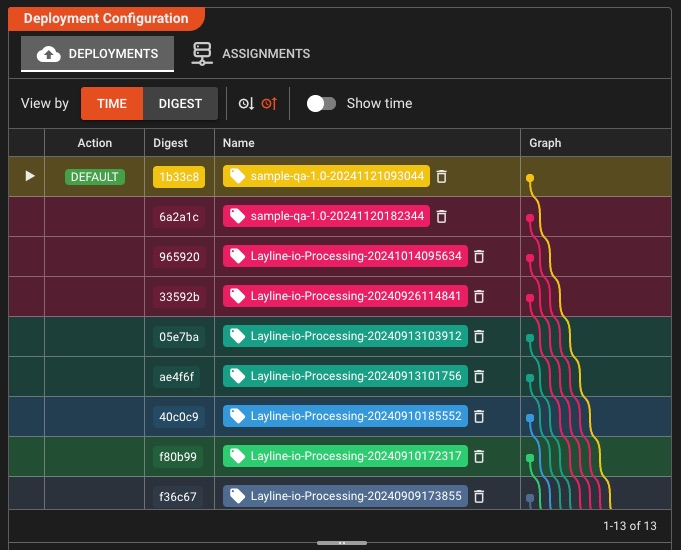
Implementación simplificada
- Implementación con un solo clic en cualquier clúster
- Propagación automática de configuraciones en todo el clúster
- No se necesita línea de comando ni configuraciones complejas
- Guía de implementación visual
- Asignar implementaciones a nodos de clúster específicos
Gestión de versiones
- Historial de implementación completo almacenado en el clúster
- Cambio fluido y sin tiempo de inactividad entre versiones
- Reversión instantánea a cualquier implementación anterior
- Actualizaciones incrementales para implementaciones existentes
Docker Contenedores
Empaquetar flujos de trabajo como contenedores livianos
- Docker Compose soporte
- Imágenes de múltiples arcos (x86/ARM)
- Imágenes base mínimas
Malla multirregional
Clústeres distribuidos geográficamente con conmutación por error automática
- Replicación entre regiones
- Conmutación por error automática
- Equilibrio de carga
- Localidad de datos
Enterprise: Implemente en todos los continentes con una latencia de sincronización <10ms
CI/CD Integración de canalización
Implemente desde CLI con automatización programable para una integración perfecta CI/CD
- Implementaciones de un solo comando con banderas
- Scriptable por Shell para automatización
- Códigos de salida para la integración de tuberías
Configuraciones de implementación granular
Cree una vez, configure muchas: cree composiciones de implementación reutilizables adaptadas a cada entorno sin duplicar flujos de trabajo.
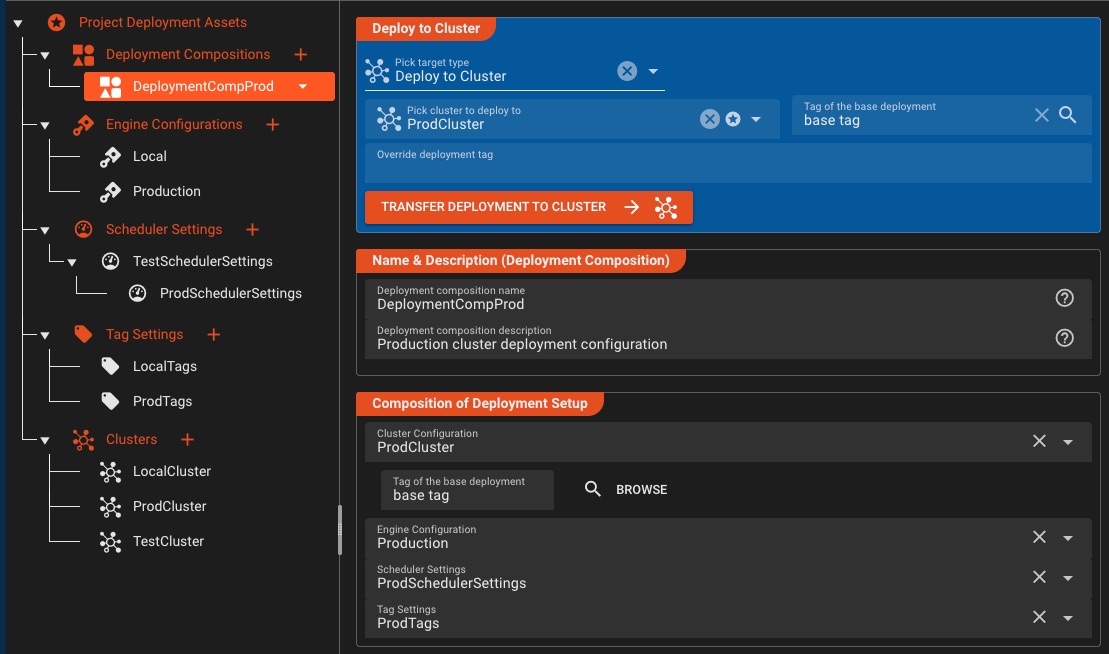
Configuraciones componibles
- Configuraciones del motor por entorno
- Configuración del programador, por ejemplo, control
- Configuración de etiquetas para la segmentación de implementación
- Las composiciones de implementación combinan todas las configuraciones
Flexibilidad del entorno
- Anular secretos por entorno
- Anulaciones de variables específicas del entorno
- Elija el clúster de destino bajo demanda
- Administre las configuraciones de prueba, desarrollo y producción de forma independiente
Implemente con precisión: Mezcle y combine configuraciones de motor, configuraciones de programador y configuraciones de etiquetas para crear composiciones de implementación que se adapten perfectamente a cada entorno, sin duplicar el flujo de trabajo.
Programación dinámica del flujo de trabajo
Escale las instancias de flujo de trabajo según demanda y distribuya la potencia de procesamiento de manera inteligente en todo su clúster
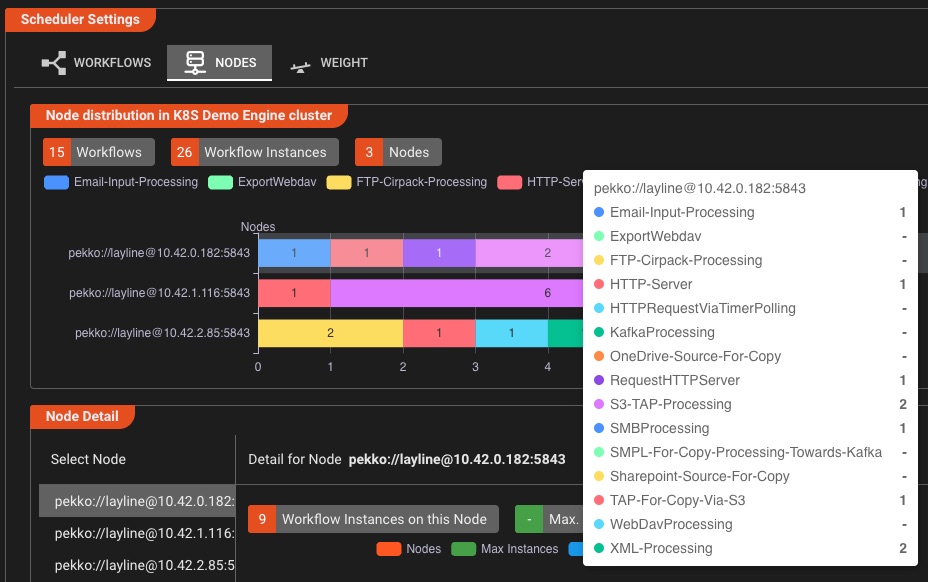
Escalado inteligente
- Ajuste las instancias del flujo de trabajo con un solo clic
- Definir límites de instancia mínimo/máximo
- Establecer prioridad de potencia de procesamiento por flujo de trabajo
- Escalado en tiempo real sin tiempo de inactividad
Distribución de conglomerados
- Visualice la distribución de carga entre nodos
- Anclar flujos de trabajo a nodos de clúster específicos
- Equilibra las cargas de trabajo automáticamente
- Supervise la distribución de instancias en tiempo real
Escale con confianza: Aumente o disminuya las instancias de flujo de trabajo sobre la marcha, asigne cargas de trabajo específicas a nodos dedicados y optimice la asignación de potencia de procesamiento, todo desde una interfaz visual intuitiva.
Enterprise Seguridad y cifrado
Seguridad de confianza cero con cifrado de clave pública y privada: protege los secretos de los desarrolladores y mantiene el acceso seguro
- Cifrado de clave pública-privada
- Almacenamiento de seguridad centralizado
- Certificados de identidad y confianza
- Acceso secreto basado en roles
- Autenticación del sistema de terceros
- más...
Confianza cero por diseño: Solo aquellos con claves privadas pueden descifrar secretos: los desarrolladores siguen siendo productivos sin exponerse a credenciales confidenciales.
Actualizaciones sin tiempo de inactividad y cambio instantáneo de versión
Actualice los flujos de trabajo en ejecución sin descartar un solo evento: el clúster conserva todas las versiones de implementación, cambie a cualquiera con un solo clic
Cambio de versión
El clúster almacena todas las versiones: cambie a cualquiera con un solo clic
Lanzamientos Canarias
Dirija el 5 % del tráfico para realizar pruebas antes del lanzamiento completo
Reversión instantánea
Volver a la versión anterior en <1 segundo
Controles de salud
Validación automática antes del cambio de tráfico.
Observabilidad y depuración
Visibilidad total de sus canales de datos con monitoreo y depuración en tiempo real
Paneles de monitoreo en tiempo real
Métricas de rendimiento en vivo e información visual para cada flujo de trabajo
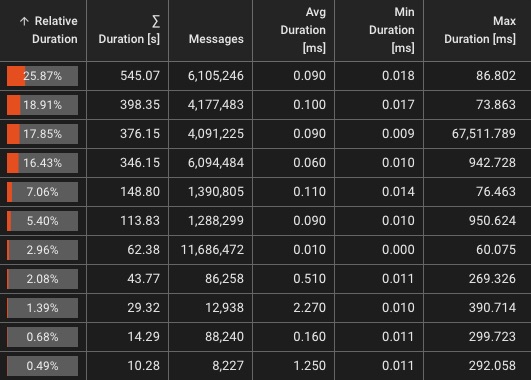
Métricas en vivo
- Rendimiento (eventos/seg)
- Tasas y tipos de error
- Métricas de mensajes
Visualizaciones
- Distribución de carga del flujo de trabajo
- Diagramas de flujo en vivo
- Rendimiento por procesador
Message Sniffing
Inspeccione los datos en vivo que fluyen a través de sus tuberías
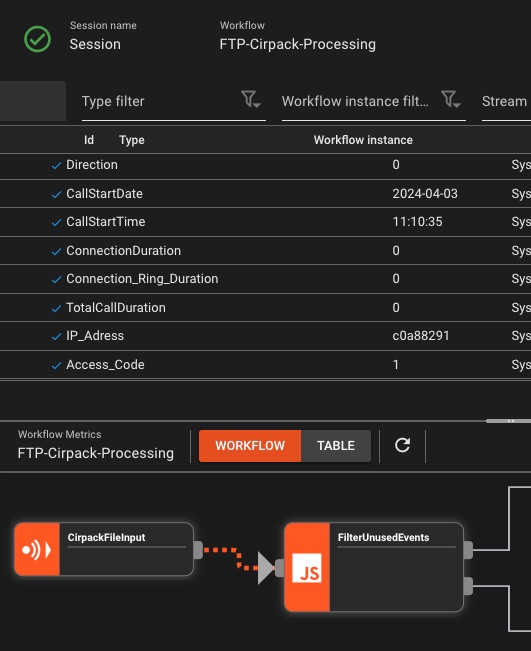
- Captura de mensajes en tiempo real
- Filtrar por contenido/metadatos
- Pantalla con reconocimiento de formato
- Exportar muestras
Consejo profesional: Sniff en cualquier procesador para ver las transformaciones en acción
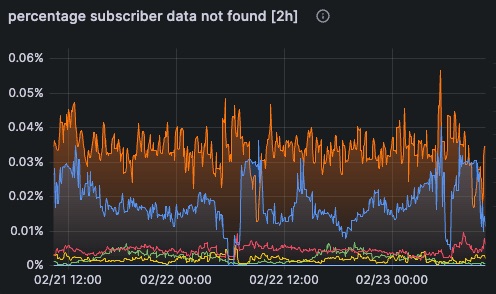
Prometheus Métricas y OpenTelemetry
Observabilidad estándar de la industria que se integra con su pila existente
Inspector de estado del motor en vivo
Profundice desde el clúster hasta los puertos de procesador individuales: vea exactamente qué está implementado y ejecutándose, sin archivos fuente
- Vista de implementación jerárquica
- Distribución de flujo de trabajo a nodo
- Recuento de instancias por nodo
- Inspección de estado a nivel de procesador
- Visibilidad de la configuración
- Estado de conexión y servicio
Transparencia de la producción: Inspeccione lo que realmente se está ejecutando en producción, desde flujos de trabajo hasta puertos individuales, incluso sin archivos fuente del proyecto. Perfecto para solucionar problemas y verificar la implementación.
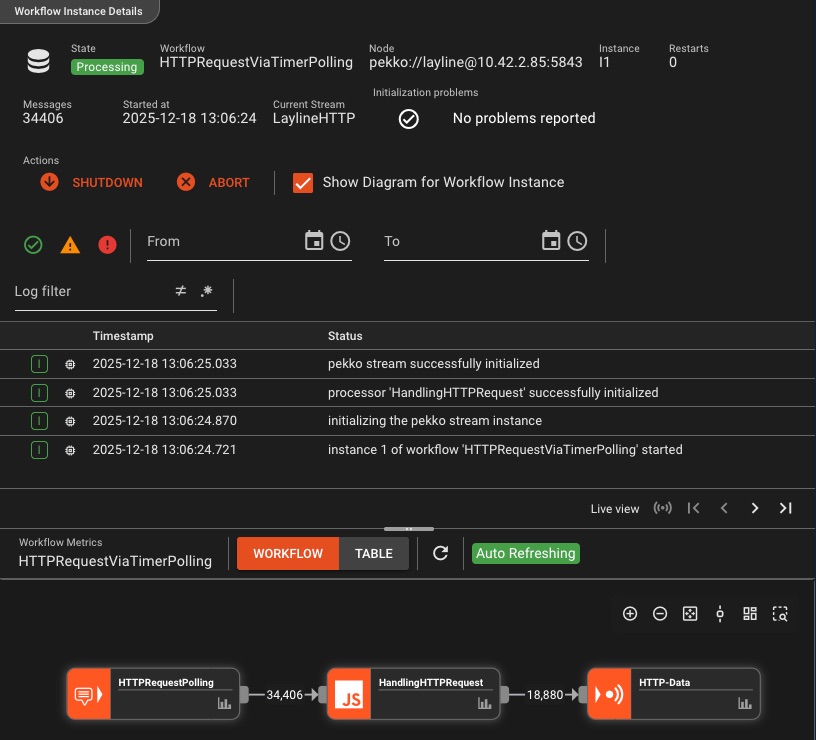
Registro completo y registro de auditoría
Cada acción, cada evento, cada error: completamente registrado y rastreable con visibilidad granular por instancia
Visibilidad granular
- Registro de instancias por flujo de trabajo
- Detalles de ejecución a nivel de flujo
- Estado y seguimiento del estado
- Contexto de error y seguimientos de pila
Control y personalización
- Mensajes de registro personalizados
- Iniciar/detener instancias de flujo de trabajo
- Filtrar por gravedad y fuente
- Historial de auditoría completo
Nunca pierdas el contexto: Desde la inicialización hasta el cierre, cada acción del flujo de trabajo se registra con marcas de tiempo precisas, lo que permite una rápida resolución de problemas y una total transparencia operativa.
Depuración de scripts en vivo en producción
Depure flujos de trabajo en ejecución en cualquier nodo del clúster con puntos de interrupción, ejecución paso a paso y manipulación de variables en tiempo de ejecución, tal como DevTools de su navegador.
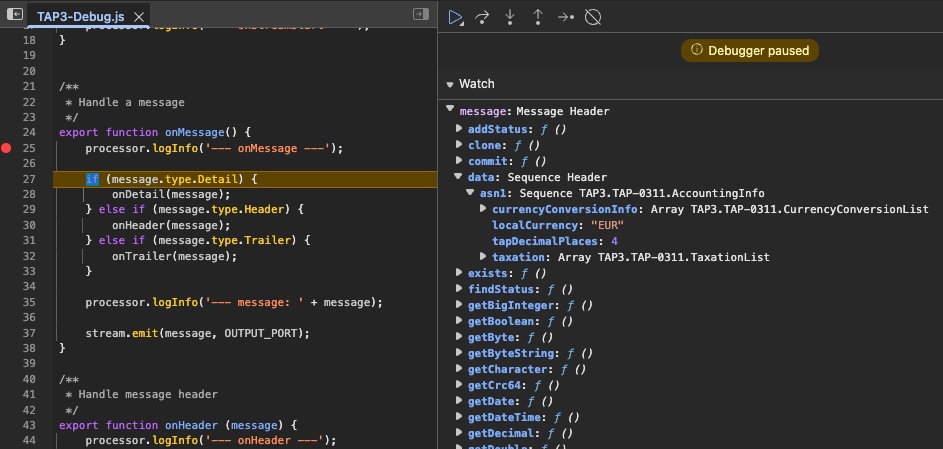
Depuración interactiva
- Establecer puntos de interrupción en cualquier script
- Recorrer el código línea por línea
- Pausar el flujo de trabajo en el punto de interrupción
- Reanudar o entrar en funciones
Inspección y manipulación en tiempo de ejecución
- Inspeccionar todas las variables y datos de mensajes.
- Modificar valores en tiempo de ejecución
- Pruebe casos extremos sobre la marcha
- Depurar en cualquier nodo del clúster
Depuración de nivel de producción: Conéctese a flujos de trabajo en vivo, establezca puntos de interrupción e inspeccione mensajes reales a medida que fluyen a través de su canalización, sin necesidad de volver a implementarlos. Cambie las variables sobre la marcha para probar correcciones al instante.
Pruebas de función de servicio interactivo
Pruebe las funciones del servicio de forma aislada: ejecute consultas de bases de datos, envíe correos electrónicos o llame a APIs directamente desde el panel sin ejecutar flujos de trabajo.
- Ejecutar funciones de forma interactiva.
- Complete los parámetros sobre la marcha
- Validación instantánea de resultados
- Pruebe las consultas DB en vivo
- Validar cualquier función de servicio.
- No se requiere flujo de trabajo
Pruebe de forma más inteligente, no más difícil: ¿Por qué reconstruir y reimplementar flujos de trabajo completos sólo para verificar una consulta de base de datos o cualquier otra función de servicio? El servicio de prueba funciona de forma independiente, se itera rápidamente y se envía con confianza.
Alertas y notificaciones inteligentes
Reciba notificaciones cuando algo salga mal, antes de que sus usuarios se den cuenta
Alertas de umbral
Activación por latencia, tasa de error y anomalías de rendimiento
Estado del flujo de trabajo
Estado de la transmisión, fallas de instancias, disponibilidad de nodos
Objetivos dinámicos
Defina objetivos de alarma sobre la marcha: correo electrónico, Teams, etc.
Reglas de alerta personalizadas
Cree plantillas, reglas y grupos objetivo
Se integra con Tu pila
Integración basada en estándares con herramientas y protocolos populares
Explorar Más
Obtenga más información sobre casos de uso, precios y cómo layline.io se adapta a sus necesidades
Descripción general del producto
Descubra la arquitectura reactiva, las capacidades de la plataforma y los fundamentos técnicos de layline.io
Más informaciónSoluciones industriales
Vea cómo los equipos de finanzas, telecomunicaciones, comercio electrónico y más utilizan layline.io
Explorar soluciones¿Por qué layline.io?
Compare layline.io con otras plataformas y vea cómo nos comparamos
Ver Comparación¿Listo para empezar?
Pruebe Community Edition gratis o programe una demostración con nuestro equipo
EmpezarAnálisis detallados de funciones y tutoriales
Descubra cómo aprovechar al máximo las potentes funciones de layline.io
IBM es propietario de Confluent. Los usuarios de Kafka siguen teniendo un problema de runtime.
El protocolo Kafka sigue siendo abierto. El centro de gravedad comercial no lo es. Siete meses después de que IBM cerrara la adquisición de Confluent, las preguntas que realmente importan son dual-run, replay y quién es el propietario del batch cuando la historia del streaming es watsonx.
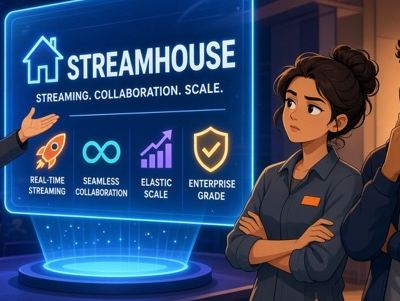
Streamhouse es la nueva palabra de moda. Esto es lo que realmente importa.
Confluent, Aiven y Redpanda quieren que creas que el streamhouse lo cambia todo. Cambia algunas cosas. Pero no resuelve el problema con el que la mayoría de los equipos están luchando realmente.
Data Products Fail When Nobody Owns the Runtime
Teams love calling their outputs 'data products.' But renaming a dashboard doesn't make it a product. The real test is who gets paged when it breaks at 2 AM — and whether they have the authority to fix it.