Del caos de datos
a conocimiento accionable en tiempo real
Crea canalizaciones de datos reactivas con un Visual Workflow Designer. Sin código de infraestructura, sin dependencia del proveedor, solo procesamiento de datos rápido y fiable a escala.
La realidad del data engineering
Crear canalizaciones de datos no debería requerir un doctorado en sistemas distribuidos. Sin embargo, la mayoría de los ingenieros de datos dedica el 80 % de su tiempo a pelear con la infraestructura en lugar de resolver problemas de negocio.
Complejidad de infraestructura
Gestión de clústeres Kafka, despliegues en Kubernetes y monitorización personalizada en múltiples entornos. Tu equipo necesita un ingeniero DevOps solo para mantener todo encendido.
Pesadillas de dependencia del proveedor
Servicios específicos de cloud que brillan en las demos, pero te atrapan en ecosistemas propietarios. Migrar termina convirtiéndose en un proyecto de seis cifras.
Tiempo hasta producción
Semanas o meses para desplegar una simple pipeline de transformación. Cuando por fin está en producción, los requisitos del negocio ya han cambiado dos veces.
Depuración de cajas negras
Cuando las pipelines fallan a las 3 de la mañana, acabas navegando por sistemas de agregación de logs repartidos entre servicios distribuidos. Encontrar la causa raíz se parece a la arqueología digital.
Mira los 4 patrones de fallo detectados en 50 postmortems ->
Cuellos de botella al escalar
Lo que gestiona 1 M de eventos se comporta de forma muy distinta con 10 M de eventos. Reescribes toda la arquitectura de tu canalización cada vez que creces.
Cómo los picos de carga provocaron el 24 % de los incidentes a escala ->
Colaboración del equipo
Los analistas de negocio no entienden tus configuraciones de Kafka. Los científicos de datos no pueden desplegar sus modelos. Todo el mundo trabaja en silos.
¿Te resulta familiar?
Te hiciste ingeniero de datos para aportar inteligencia a los procesos de negocio, no para convertirte en ingeniero de fiabilidad del sitio a tiempo completo. Hay una forma mejor.
Ver la soluciónFlujos de trabajo visuales.
Resultados reales.
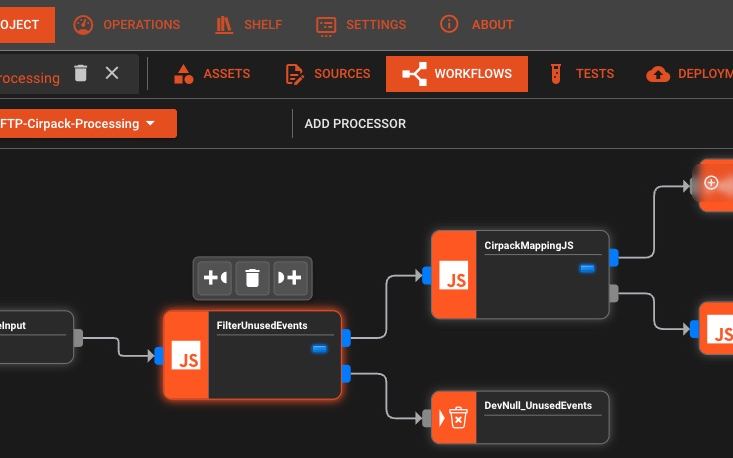
Crea pipelines de datos conectando bloques, no escribiendo YAML. Observa cómo fluyen tus datos en tiempo real con monitorización y gestión de errores integradas.
Diseñador de arrastrar y soltar
Creación visual de canalizaciones con procesadores configurables. No hace falta programar, solo conectar los bloques.
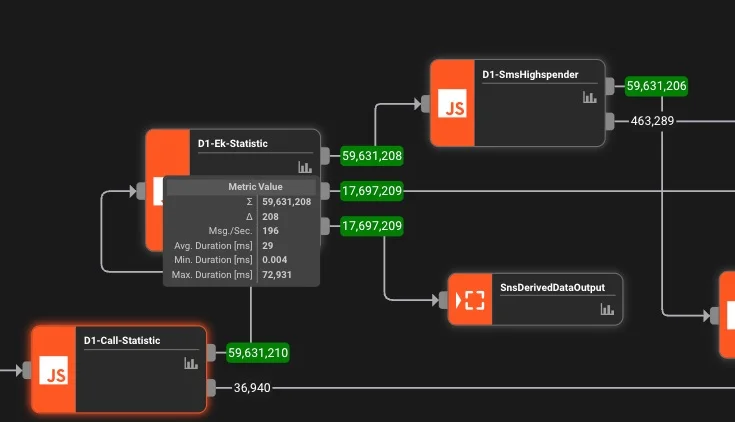
Monitorización en tiempo real
Métricas en vivo, seguimiento de errores e indicadores de rendimiento. Ve exactamente qué está ocurriendo en tu canalización.
Cero trabajo de infraestructura
Funciona en tu infraestructura o en la nuestra. Autoescalado, alta disponibilidad y operación sin mantenimiento.
La revolución del
data engineering
Deja de pelear con la infraestructura. Empieza a construir soluciones que de verdad importan.
Despliega en minutos
Sáltate meses de configuración de infraestructura. Nuestro diseñador visual te permite crear canalizaciones de producción más rápido que escribir un consumidor de Kafka.
Duerme tranquilo
Monitorización integrada, reintentos automáticos y gestión de colas de mensajes fallidos. Tus canalizaciones se recuperan solas mientras tú te centras en la lógica de negocio.
Escala sin esfuerzo
Del prototipo a la escala de producción. Gestiona picos de tráfico sin reescribir código ni aprovisionar servidores.
En resumen
Deja de luchar con la infraestructura. Céntrate en lo que realmente hace avanzar a tu negocio.
"Por fin, una plataforma de datos que simplemente funciona."
Mira layline.io
en acción
Soluciones reales de equipos reales de ingeniería de datos en distintos sectores
Panel de analítica en tiempo real
Una empresa de comercio electrónico procesa más de 50.000 eventos por segundo procedentes de clics web, compras y cambios de inventario para impulsar paneles en vivo y motores de personalización.
Preguntas de ingenieros de datos
Preguntas habituales sobre la implementación de procesamiento de datos en tiempo real con layline.io.
La mayoría de los ingenieros de datos tienen a layline.io procesando sus primeros flujos de datos en menos de 10 minutos. Nuestro constructor visual de canalizaciones y los conectores preconfigurados eliminan semanas de desarrollo a medida.
layline.io se conecta a bases de datos, API REST, colas de mensajes, sistemas de archivos, plataformas de flujo y protocolos personalizados. Gestiona JSON, XML, ASCII, binario, ASN.1, HTTP y más mediante configuración visual.
layline.io está diseñado para escala empresarial y procesa millones de eventos por segundo con escalado horizontal. Nuestra arquitectura distribuida garantiza un rendimiento constante incluso durante picos de tráfico, con gestión de backpressure integrada.
Sí. Despliega en tus instalaciones, en cualquier nube o en híbrido. layline.io funciona con tus bases de datos, lagos de datos, almacenes y herramientas analíticas existentes sin requerir cambios de arquitectura.
Ofrecemos soporte técnico, documentación, videotutoriales y guía de incorporación. Nuestro equipo ayuda a los equipos de ingeniería de datos a optimizar sus canalizaciones en rendimiento y fiabilidad.
Los precios de layline.io escalan con tu uso. Pagas solo por lo que procesas, con una estructura predecible que crece con tu negocio. Los planes empresariales incluyen soporte dedicado y SLA personalizados.
Crea tu primera canalización en minutos
Descarga layline.io gratis y empieza a crear canalizaciones de datos reactivas sin la complejidad habitual. No se requiere tarjeta de crédito.
Recursos para ingenieros de datos
Casos de uso, guías técnicas y mejores prácticas para crear canalizaciones de datos
IBM es propietario de Confluent. Los usuarios de Kafka siguen teniendo un problema de runtime.
El protocolo Kafka sigue siendo abierto. El centro de gravedad comercial no lo es. Siete meses después de que IBM cerrara la adquisición de Confluent, las preguntas que realmente importan son dual-run, replay y quién es el propietario del batch cuando la historia del streaming es watsonx.
Streamhouse es la nueva palabra de moda. Esto es lo que realmente importa.
Confluent, Aiven y Redpanda quieren que creas que el streamhouse lo cambia todo. Cambia algunas cosas. Pero no resuelve el problema con el que la mayoría de los equipos están luchando realmente.
Data Products Fail When Nobody Owns the Runtime
Teams love calling their outputs 'data products.' But renaming a dashboard doesn't make it a product. The real test is who gets paged when it breaks at 2 AM — and whether they have the authority to fix it.