Di Andrew Tan
La demo che non invecchia mai
Ecco come di solito viene presentato Iceberg:
Un ingegnere è davanti a uno schermo ed esegue una query su un dataset Parquet. Poi esegue la stessa query su una tabella Iceberg. I risultati sono identici. Il pubblico annuisce. Poi l'ingegnere mostra il time travel — tornando a una snapshot precedente — e la sala inizia davvero a mormorare. Qualcuno chiede dell'evoluzione dello schema. L'ingegnere aggiunge una colonna, non riscrive nulla e le query vecchie continuano a funzionare. Il comitato è convinto.
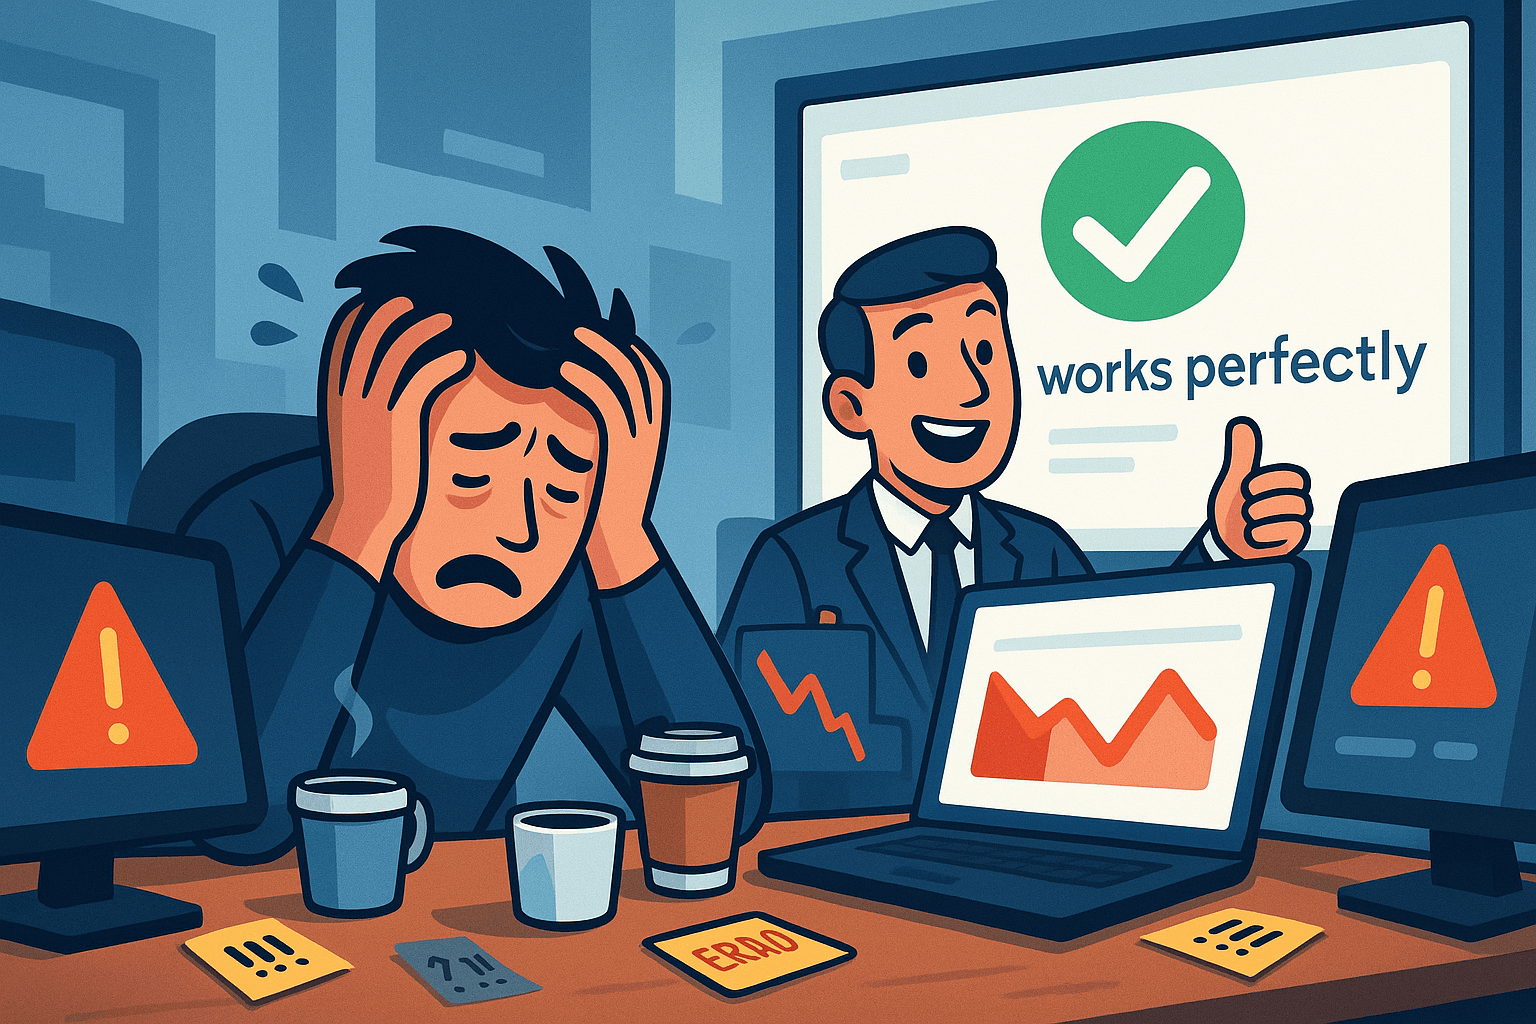
Sei mesi dopo, la stessa squadra è in un'altra stanza. Questa non ha schermi. Solo un foglio di calcolo, un elenco di allarmi in crescita e una domanda che nessuno ha fatto durante la demo:
Chi si occupa della compattazione?
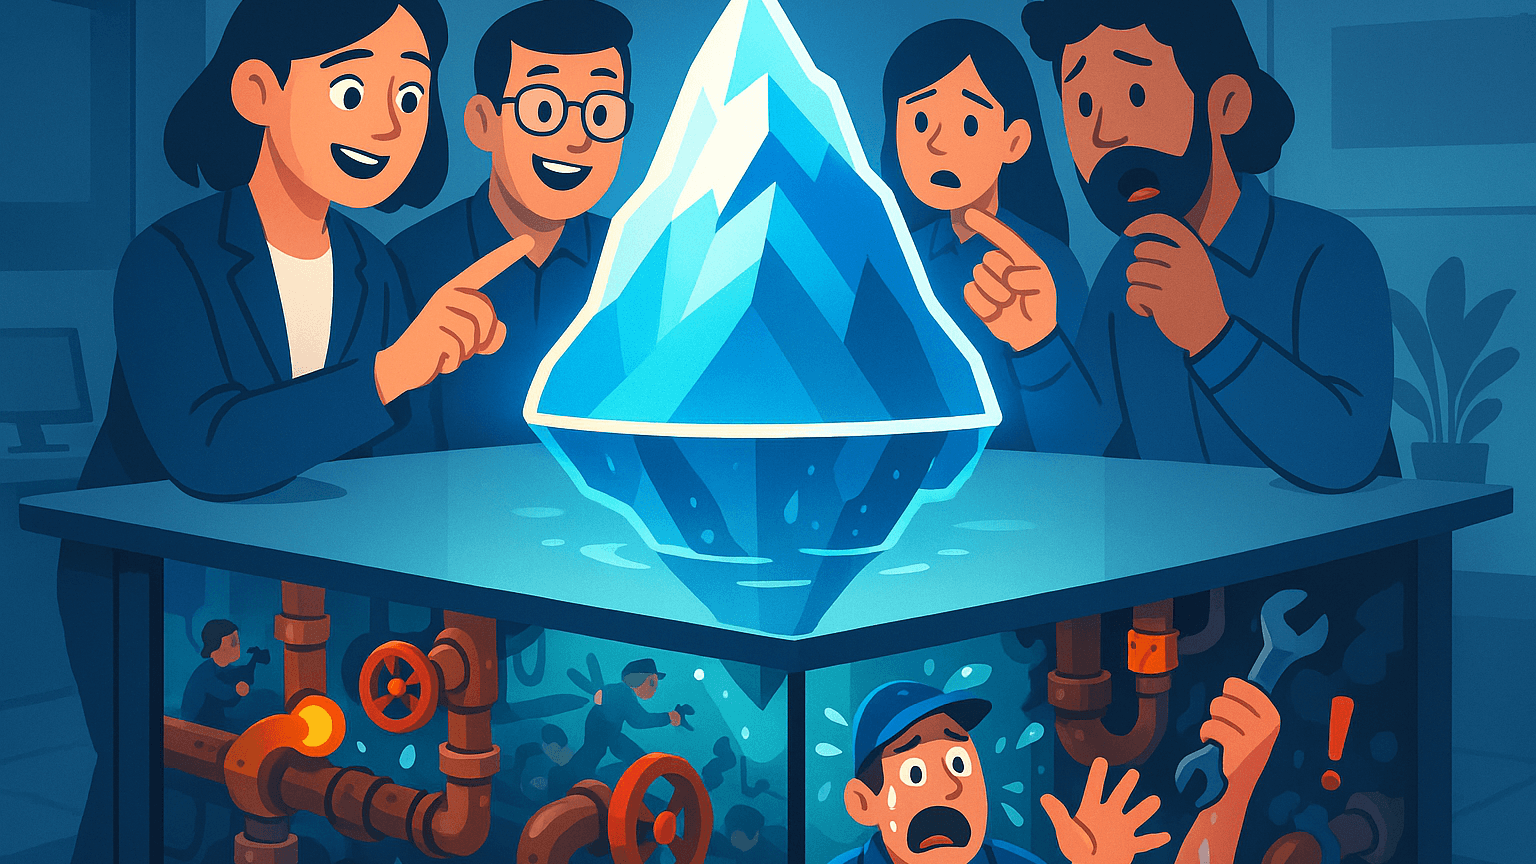
La demo ha mostrato cosa Iceberg rende possibile. Non ha mostrato cosa Iceberg rende tuo problema.
Cosa promette la specifica rispetto a cosa eredita la squadra
I formati di tabella aperti sono un progresso reale. La portabilità tra motori, l'isolamento delle snapshot, l'evoluzione delle partizioni e il partizionamento nascosto sono capacità reali che risolvono problemi reali. Se stai cercando di liberarti da un data warehouse bloccato da un fornitore, Iceberg, Delta Lake e Hudi sono le migliori vie d'uscita.
Ma la specifica non è il sistema. La specifica dice come devono essere organizzati i metadati. Non dice come la tua squadra dovrebbe impedire che quei metadati crescano senza limiti, come coordinare la compattazione tra più writer o cosa succede quando due diversi motori di query non concordano sulla snapshot da leggere.
Ecco cosa salta la demo:
La compattazione non è automatica
Ogni inserimento, aggiornamento e cancellazione crea nuovi file e nuove voci di metadati. Lasciati a se stessi, tabelle ad alta velocità accumulano migliaia di file piccoli. Le prestazioni delle query peggiorano. I file di metadati crescono. La tabella che sembrava veloce nella demo inizia a andare in timeout in produzione. Qualcuno deve pianificare la compattazione, monitorarla, ottimizzarla e gestire i fallimenti quando due job cercano di riscrivere la stessa partizione.
La proliferazione di cataloghi è reale
Le tabelle Iceberg hanno bisogno di un catalogo: Hive, Glue, Nessie, Polaris, un servizio REST personalizzato. Ogni catalogo ha il proprio modello di consistenza, la propria autenticazione, il proprio ciclo di aggiornamento. Una squadra che adotta Iceberg per evitare il lock-in del fornitore finisce spesso per gestire due o tre sistemi di catalogo invece di un warehouse. Il lock-in si sposta dal formato di storage al layer di catalogo.
La policy di retention è un problema distribuito
Quando una snapshot scade, Iceberg marca i dati come irraggiungibili. Ma i file sottostanti esistono ancora nell'object storage finché qualcosa non li cancella. Quel "qualcosa" è il tuo problema. Se imposti una retention aggressiva per risparmiare storage, potresti perdere la capacità di tornare indietro quando un job a valle produce risultati errati. Se conservi tutto, il conto dello storage cresce mentre il tuo bucket S3 si trasforma in uno scavo archeologico.
Batch e streaming vedono tabelle diverse
Un job batch che scrive su Iceberg produce file grandi e ben strutturati. Un job streaming produce file piccoli e frequenti. Se entrambi i percorsi scrivono sulla stessa tabella, il query planner deve gestire due layout di file radicalmente diversi. Il percorso streaming ha bisogno di compattazione frequente per rimanere leggibile. Il percorso batch ha bisogno di file stabili per evitare ricalcoli. Coordinare questi due ritmi in una sola tabella è più difficile di quanto suggeriscano i diagrammi architetturali.
La demo mostrava un unico writer e un unico reader. In produzione raramente funziona così.
Perché "aperto" crea nuova frammentazione
La promessa dei formati di tabella aperti è l'interoperabilità. Interroga gli stessi dati da Spark, Trino, Flink, DuckDB, Snowflake, BigQuery. In pratica, ogni motore supporta un sottoinsieme diverso della specifica a un livello di maturità diverso.
Un motore supporta le cancellazioni posizionali ma non quelle per uguaglianza. Un altro supporta il time travel ma solo per tabelle scritte dal proprio catalogo. Un terzo supporta l'evoluzione delle partizioni ma richiede una specifica versione del formato dei metadati che rompe i reader più vecchi. La tabella è "aperta" in teoria. In pratica, è accoppiata alla specifica combinazione di motori e versioni di catalogo che la tua squadra esegue.
Questa non è una critica ai progetti in sé. Iceberg, Delta e Hudi si muovono velocemente e migliorano rapidamente. Il problema è che le squadre li adottano aspettandosi liberazione e scoprendo una nuova superficie operativa. Invece di un unico venditore da incolpare, hanno una matrice di compatibilità di versioni da gestire.
Il costo nascosto è il carico cognitivo. I tuoi data engineer ora devono capire non solo le loro pipeline, ma la pianificazione della compattazione, il modello di consistenza del catalogo, la versione del formato dei metadati e i comportamenti specifici di ogni motore che tocca la tabella. Quell'esperienza non viene da una demo.
La checklist che nessuno esegue prima dell'adozione
Se la tua squadra sta valutando un formato di tabella aperto, queste sono le domande che contano più delle prestazioni delle query in un benchmark:
Chi possiede la compattazione, e cosa succede quando fallisce?
La compattazione non è una configurazione una tantum. È un processo continuo in background che compete per le stesse risorse di calcolo delle tue query di produzione. Se la compattazione rimane indietro, le query rallentano. Se la compattazione corrompe una partizione, il ripristino è manuale e stressante. Hai bisogno di un proprietario, di un runbook e di un modo per rilevare quando la compattazione non regge il passo.
Qual è la tua strategia di uscita dal catalogo?
I cataloghi sono il vero punto di lock-in. Se oggi ti impegni con Glue, domani puoi migrare a Nessie o Polaris senza riscrivere i percorsi delle tabelle e riconfigurare ogni job a valle? La maggior parte delle squadre non lo testa finché non è costretta.
Come gestisci i dati in ritardo e i backfill?
I backfill batch e i dati in ritardo dello streaming riscrivono entrambi partizioni storiche. I formati di tabella aperti gestiscono questo meglio del Parquet grezzo, ma non eliminano il problema del coordinamento. Se un backfill viene eseguito mentre un job streaming sta aggiungendo dati alla stessa partizione, devi capire la semantica di isolamento, il comportamento di retry e esattamente cosa fa ogni motore quando vede un conflitto.
Qual è il tuo piano di crescita dei metadati?
I file di metadati sono piccoli ma si moltiplicano. Una tabella con snapshot giornaliere e compattazione oraria può generare migliaia di file di metadati al mese. L'object storage è economico, ma le operazioni LIST non sono gratuite. Alcuni motori di query caricano l'intero albero dei metadati in memoria. A una certa scala, i metadati stessi diventano un collo di bottiglia delle prestazioni.
Chi viene allertato quando una query restituisce risultati sbagliati?
L'isolamento delle snapshot è fantastico finché qualcuno non legge dalla snapshot sbagliata perché il catalogo è stato temporaneamente inconsistente. O perché un job streaming ha commesso un batch incompleto. O perché due motori hanno interpretato lo stesso file di metadati in modo diverso. Il debug di questi problemi richiede competenze sul formato, sul catalogo e sul motore specifico. Il turno di reperibilità si è appena allungato.
Se non riesci a rispondere a queste domande con qualcosa di più specifico di "lo risolveremo," non stai adottando una tecnologia. Stai assumendo un nuovo dominio operativo.
Dove il compromesso vale la pena
Voglio essere equo. Ci sono situazioni in cui i formati di tabella aperti sono la scelta giusta:
Stai attivamente cercando di sfuggire al lock-in del fornitore.
Se il tuo provider di warehouse aumenta i prezzi, depreca funzionalità o limita l'egress, la portabilità di un formato aperto vale l'overhead operativo. L'alternativa è rimanere intrappolati.
Hai davvero bisogno di time travel e rollback.
Alcuni carichi di lavoro — specialmente in settori regolamentati o nei servizi finanziari — richiedono la capacità di ricostruire lo storico in modo esatto. Il modello a snapshot qui non è un optional. È un requisito di compliance.
Esegui più motori di calcolo sugli stessi dati.
Se il tuo team di analytics usa Spark, il team BI usa Trino e la pipeline ML usa DuckDB, un formato di tabella aperto condiviso elimina la danza di estrazione-trasformazione-caricamento tra sistemi. Il costo di coordinamento è reale, ma è inferiore a mantenere tre copie separate dello stesso dataset.
Hai la squadra adatta.
Se hai ingegneri che capiscono i formati dei metadati, le strategie di compattazione e i modelli di consistenza dei cataloghi, l'onere operativo è gestibile. Se non li hai, stai esternalizzando l'esperienza a consulenti e sperando che restino disponibili.
Dove entra in gioco layline.io
In layline.io non vendiamo un formato di tabella. Vendiamo un runtime di elaborazione che gestisce carichi di lavoro sia batch che streaming sull'infrastruttura che già hai. Questo include formati di tabella aperti quando hanno senso, e storage tradizionale quando non ne hanno.
Il motivo per cui questo conta: molte squadre adottano Iceberg perché hanno bisogno che batch e streaming coesistano, e hanno sentito dire che i formati di tabella aperti sono l'unico modo per unificarli. Non è vero. L'unificazione avviene allo strato di elaborazione, non allo strato di storage. Se il tuo runtime può scrivere file ben strutturati in modalità batch e gestire micro-batch in modalità streaming — gestendo compattazione, backfill e dati in ritardo nello stesso workflow — il formato di storage diventa una scelta di configurazione, non un impegno architetturale.
Vediamo squadre che hanno adottato Iceberg per le giuste ragioni e poi hanno scoperto che la parte difficile non è mai stata il formato. Era il coordinamento operativo intorno ad esso: mantenere coerenti i percorsi batch e streaming, gestire i cambi di schema senza rompere i consumatori a valle e assicurarsi che la stessa logica di business produca gli stessi risultati indipendentemente da quando arrivano i dati.
Questo è il problema su cui ci concentriamo. Il formato della tabella è un dettaglio. Il modello operativo è ciò che determina se il sistema funziona alle 2 di notte di un martedì.
La domanda da fare prima della demo
La prossima volta che un fornitore ti mostra una demo impeccabile di Iceberg — time travel, evoluzione delle partizioni, cambio di motore che sembra senza sforzo — chiedigli questo:
"Mostrami la pianificazione della compattazione. Mostrami il failover del catalogo. Mostrami cosa succede quando un job streaming e un backfill batch colpiscono la stessa partizione. Mostrami il conto dello storage dopo sei mesi di crescita dei metadati. E mostrami chi viene allertato quando un motore di query legge una snapshot scritta parzialmente."
Se la risposta è un riferimento alla documentazione, stai guardando la parte facile. La parte difficile è ciò che possederai per i prossimi tre anni.
I formati di tabella aperti non sono una truffa. Sono una tecnologia reale e preziosa con un costo operativo reale che il marketing raramente menziona. Le squadre che hanno successo sono quelle che quantificano quel costo in anticipo, assegnano la proprietà prima che venga creata la prima tabella e trattano il formato come un componente di un sistema operativo più ampio — non come uno strato magico che fa sparire i problemi dell'infrastruttura.
La demo è l'inizio. Il conto della manutenzione è dove la storia comincia davvero.
Se la tua squadra sta valutando i formati di tabella aperti e cerca di capire il costo totale di proprietà, mettiti in contatto. Lavoriamo con squadre esattamente su questo problema — e la realtà operativa è solitamente più gestibile della paura, una volta che sai cosa pianificare.
Andrew Tan è un imprenditore seriale e fondatore di layline.io, che costruisce infrastrutture di elaborazione dati aziendali in grado di gestire carichi di lavoro sia batch che real-time su larga scala.