Approfondimenti & Aggiornamenti
Articoli, tutorial e approfondimenti su integrazione dati, elaborazione eventi e creazione di Workflows scalabili.
Streamhouse è il nuovo buzzword. Ecco la parte che conta davvero.
Confluent, Aiven e Redpanda vogliono farti credere che lo streamhouse cambi tutto. Cambia alcune cose. Ma non risolve il problema con cui la maggior parte dei team sta realmente lottando.
Data Products Fail When Nobody Owns the Runtime
Teams love calling their outputs 'data products.' But renaming a dashboard doesn't make it a product. The real test is who gets paged when it breaks at 2 AM — and whether they have the authority to fix it.
dbt sta lasciando il magazzino. I tuoi Data Pipeline sono pronti?
dbt ha costruito il moderno workflow di analisi. Ora il livello di trasformazione si sta spostando a monte — e il divario tra i modelli SQL e l'esecuzione runtime sta diventando il collo di bottiglia che nessuno aveva previsto.
Iceberg è facile da dimostrare. Il conto della manutenzione arriva dopo.
I formati di tabella aperti risolvono la portabilità. Non risolvono le operazioni. Il lavoro vero inizia dopo il post di lancio: compattazione, retention, proliferazione di cataloghi multipli e mantenere coerenti i percorsi batch e streaming.
La compliance fallisce in transito: perché la governance dei dati deve entrare nella pipeline
La maggior parte dei programmi di governance si concentra sui dati a riposo. Il vero punto di rottura è rappresentato dai dati in movimento — feed CDC, job di arricchimento, join in streaming e Workflow attivati da AI. Ecco com'è la governance quando la applichi mentre i dati sono ancora in movimento.
Abbastanza Fresco per un Agente AI? Il Budget di Freschezza dei Dati che Nessuno Definisce
La maggior parte dei team parla del contesto AI come un problema di archiviazione. La domanda più difficile è se i dati siano abbastanza freschi per l'azione che l'agente sta per intraprendere.
Perché l'85% delle imprese non è pronto per l'AI
Il benchmark del 2026 di Fivetran ha rilevato che l'85% delle imprese utilizza AI agentica su infrastrutture che non sono pronte. Il problema non è il modello. Sono i data pipeline che lo alimentano.
I costi nascosti della creazione del proprio strato di integrazione Batch-Streaming
Con la programmazione assistita dall'IA, costruire i propri data pipeline sembra più economico che mai. Ma i veri costi non sono nella costruzione iniziale, bensì nella manutenzione, nelle rotazioni di reperibilità e nella complessità accumulata che si complica nel tempo.
Il mercato dell'orchestrazione si sta consolidando. Ecco perché è una buona notizia per i team di dati.
Dagster entra a far parte di Prefect, il che segna la fine degli orchestratori standalone. I vincitori saranno piattaforme unificate che combinano orchestrazione ed elaborazione — ed è esattamente la direzione verso cui si sta muovendo il mercato.
Il CDC è l'impianto idraulico che tutti dimenticano finché non si rompe
Change Data Capture è lo strato invisibile che abilita analytics in tempo reale e sistemi event-driven — ma la maggior parte dei team ci pensa solo dopo il primo incidente di produzione
Il Tuo Data Warehouse Non È La Tua Data Pipeline
I team continuano a costringere il loro data warehouse a svolgere lavoro di integrazione per cui non è mai stato progettato. Il risultato sono costi che esplodono, fallimenti opachi e architetture che diventano più difficili da manutenere man mano che "hanno successo". Ecco perché ha senso separare lo spostamento dei dati dallo storage analitico.
Il divario di produttività dell'IA: Perché i numeri non tornano
Ogni dashboard aziendale afferma che l'IA sta trasformando il business. I numeri reali sulla produttività raccontano una storia molto diversa — e capire il perché è importante per ogni team che prende decisioni sugli investimenti in IA.
L'Ingegnere dei Dati AI: Cosa è Veramente Cambiato (E Cosa No)
Ogni blog concorrente sta pubblicando 'L'AI sta cambiando l'ingegneria dei dati.' È tutto enfatico e vago. Ecco l'inventario onesto — cosa gli strumenti LLM aiutano veramente, cosa ancora non possono toccare, e perché le affermazioni di '80% automazione' non sopravvivono al contatto con la produzione.
I contratti dati sono il versioning delle API di cui il tuo Data Pipeline ha bisogno
La deriva dello schema continua a rompere i pipeline perché stiamo monitorando i cambiamenti invece di imporre contratti. Ecco perché i contratti dati sono il livello mancante tra i tuoi produttori e consumatori.
La Data Lineage è una Vanity Metric Senza Contesto Aziendale
La maggior parte degli strumenti di lineage produce diagrammi belli da vedere che non rispondono alla domanda fondamentale: 'Cosa si rompe se questi dati sono sbagliati?' Ecco come passare dal teatro dell'osservabilità a una lineage critica per il business.
Perché ho smesso di credere alle 'Best Practices' e ho iniziato a fidarmi di 'Funziona per noi'
Ho passato 18 mesi a costruire l'architettura 'perfetta'. Poi ho visto un cliente cancellarla in 20 minuti e sostituirla con un cron job. Ecco cosa ho imparato sulla trappola delle 'best practice' — e perché la tecnologia noiosa spesso vince.
Cosa ho imparato leggendo 50 postmortem di Data Pipeline
Dopo aver analizzato 50 postmortem pubblici di Uber, Netflix, Stripe, e altri, emergono quattro schemi di fallimento che si ripetono più e più volte. La maggior parte di essi è prevenibile nella fase di progettazione.
Non Hai Evitato la Complessità di Airflow — L'hai Solo Distribuita
Aggiungere Kestra, Dagster o Prefect insieme ad Airflow non riduce la complessità dell'orchestrazione. La moltiplica. Ecco come appare realmente il debito di coordinamento nascosto — e cosa fare al riguardo.
Perché il tuo team di dati non può consegnare: il collo di bottiglia organizzativo di cui nessuno parla
Il più grande ostacolo alla produttività del team di dati non è la tecnologia—è l'attrito organizzativo. Ecco come le catene di approvazione, la frammentazione della toolchain e la proprietà poco chiara creano colli di bottiglia che nessun talento ingegneristico può superare.
Qlik acquisisce Talend – Osservazioni sui rinnovi post-acquisizione e alternative.
Alcuni clienti di Talend hanno segnalato aumenti significativi nei prezzi di rinnovo a seguito dell'acquisizione di Talend da parte di Qlik. Questo articolo condivide informazioni disponibili pubblicamente ed esperienze individuali dei clienti e delinea cosa dovrebbero considerare le aziende che valutano le loro opzioni.
Cosa Succede al Tuo Data Pipeline Quando il Sistema Sorgente Cambia Senza Preavviso
La deriva dello schema e le modifiche a monte che interrompono il flusso sono la causa principale dei fallimenti silenziosi dei dati. Ecco come evitare di essere colti di sorpresa.
Cosa Succede al Tuo Data Pipeline Quando il Sistema Sorgente Cambia Senza Preavviso
La deriva dello schema e i cambiamenti a monte che interrompono il sistema sono la causa principale dei fallimenti silenziosi dei dati — ma la maggior parte dei contenuti sui data pipeline si concentra sull'infrastruttura, non sul comportamento del sistema sorgente
Integrazione dei Dati Finanziari: Una Guida Pratica
Cos'è l'integrazione dei dati finanziari? Scopri perché integrare i dati finanziari è particolarmente difficile, come differisce dall'ETL regolare, e i modelli comprovati che i team utilizzano per risolverlo.
layline.io vs. Apache Kafka: Quando Scegliere Cosa
Un confronto pratico degli approcci di elaborazione dei flussi — coprendo latenza, complessità operativa e l'adattamento del team che determina effettivamente la scelta giusta
Perché l'Integrazione Dati in Tempo Reale è Importante per le Applicazioni Moderne
La differenza tra quasi-tempo-reale e realmente-tempo-reale, e perché la differenza costa più di quanto pensi
Perché la maggior parte dei Data Pipeline falliscono alle 3 del mattino (e come costruirne di resistenti)
Le vere ragioni per cui i data pipeline di produzione si rompono nel cuore della notte — e le pratiche ingegneristiche che lo prevengono
La Migrazione Streaming Che Nessuno Ha Chiesto
Un architetto dei dati di una Fortune 500 una volta mi ha detto che hanno passato 14 mesi a migrare a Kafka — poi hanno silenziosamente riportato metà dei pipeline al batch. Ecco perché continua a succedere e cosa farei invece.
Quando i tuoi Data Pipeline di Airflow devono diventare in Real-time
Hai Airflow in esecuzione. Il tuo team lo conosce. I DAG funzionano. Allora perché senti improvvisamente dire 'abbiamo bisogno del real-time' — e cosa puoi fare effettivamente al riguardo?
Edge Processing che Effettivamente Risparmia Denaro
Come il Filtro Dati Locale Può Ridurre la Tua Fattura Cloud del 90% — E Come Potrebbe Essere la Tua
Dai Batch allo Streaming: Una Guida Pratica ai Moderni Data Pipeline
Perché i dati in real-time sono importanti, cosa rende difficile la migrazione e come pensare alla transizione — che si scelga layline.io o un'altra strada
Il tuo conto Cloud ha chiamato. Vuole parlare di Serverless.
Dalla scalabilità invisibile alle fatture invisibili—perché i team di ingegneria stanno abbandonando FaaS per motori di dati persistenti e prevedibili.
Scopri la Potenza di Apache Pekko con layline.io
Presso layline.io, abbiamo sfruttato le robuste capacità di Apache Pekko per offrirti una piattaforma di elaborazione eventi low-code completa. Con la nostra soluzione, puoi sfruttare tutto il potenziale di Apache Pekko senza scrivere una sola riga di codice.
La Potenza della Data Orchestration con layline.io: Uno Scenario di Showcase di Ubiquity Unifi
In un'era in cui i dati dominano sovrani, gestire e orchestrare il vasto mare di informazioni è diventato la spina dorsale di numerose aziende e industrie.
layline.io: Rivoluzionando la scena delle startup IT di Amburgo con l'esperienza nell'elaborazione dei dati di evento
layline.io selezionata come una delle startup IT più influenti ad Amburgo, Germania da EU Startup News.
H-Hotels.com - Trasformazione Digitale con layline.io
L'industria dell'ospitalità ha visto significativi progressi tecnologici negli ultimi anni. Questo include il software di Data Integration come uno degli strumenti più critici che l'industria può sfruttare per ottimizzare le proprie operazioni.
Il Vantaggio dell'Elaborazione Dati Asincrona Basata su Eventi
Nel mondo frenetico di oggi, ogni azienda cerca modi migliori per elaborare grandi volumi di dati. I metodi tradizionali di elaborazione dati hanno le loro limitazioni, motivo per cui le aziende stanno esplorando sempre più l'elaborazione dati asincrona basata su eventi.
layline.io - Un Confronto con Kafka
Come si confronta layline.io con Kafka? Questa è una domanda che sentiamo di tanto in tanto. Ci chiediamo perché.

Serie di Esempi: Richieste Http-Client
Le interfacce ReST sono popolari e abbondanti. Ti mostriamo come configurare le richieste Http-Client all'interno di layline.io utilizzando Yahoo Finance come esempio.
Sniffing Real-Time Data
È difficile capire cosa stia realmente accadendo in scenari di elaborazione complessi. layline.io aiuta fornendo strumenti di analisi per ottenere approfondimenti sul funzionamento interno di Workflows complessi durante l'esecuzione.
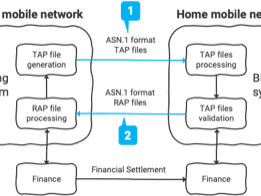
Configurazione del Formato ASN.1
ASN.1 è ancora un formato di dati popolare. Scopri quanto è facile configurare qualsiasi formato ASN.1 in layline.io.
Maledetto quell'inferno dei formati dati
Gestire formati dati complessi e cambiamenti può essere scoraggiante. Scopri come layline.io affronta questa sfida utilizzando un linguaggio grammaticale configurabile.

Output su Kafka
Dimostrazione su come leggere dati da un file strutturato, mappare i dati dei record e inviare i dati al cloud Kafka.
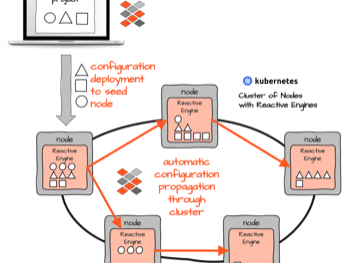
Vantaggi dei Workflows di layline.io rispetto ai tradizionali Microservizi utilizzando il modello K8S/Docker
Il modello tradizionale di Microservizi su Kubernetes/Docker presenta alcuni svantaggi che portano a una gestione e un consumo di risorse eccessivamente complessi. Spieghiamo il contesto e come layline.io può essere d'aiuto.
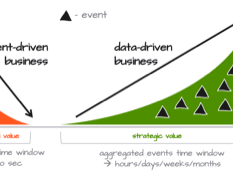
Event-driven o niente!? Ti stai perdendo qualcosa se la tua azienda non è event-driven?
Potresti perderti qualcosa se sei solo data-driven. In effetti, ogni azienda è data-driven. Ma dovresti chiederti cosa significhi davvero e se sarà sufficiente per il tuo futuro.
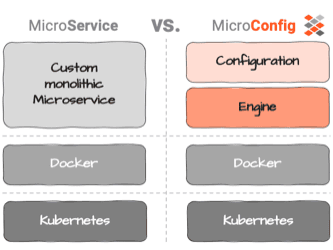
Correggere ciò che non va con i Microservices
Da alcuni anni i Microservices e le architetture orientate ai servizi sono di gran moda. Ma ci sono degli svantaggi. Possono essere superati?
Gestire la pressione dei dati nei sistemi basati su messaggi
Come gestire la pressione dei dati in soluzioni basate su messaggi non-stop e garantire un funzionamento continuo sotto carico.
Resta aggiornato
Ricevi gli ultimi articoli, tutorial e aggiornamenti direttamente nella tua casella di posta.
Nessuno spam. Disiscrizione in qualsiasi momento.