Tutte le funzionalità di cui hai bisogno. Niente che non lo fai.
Dai flussi di lavoro visivi ai formati di dati esotici fino all'implementazione di livello carrier: layline.io offre ai team di progettazione gli strumenti per creare pipeline di dati in tempo reale senza appesantire.
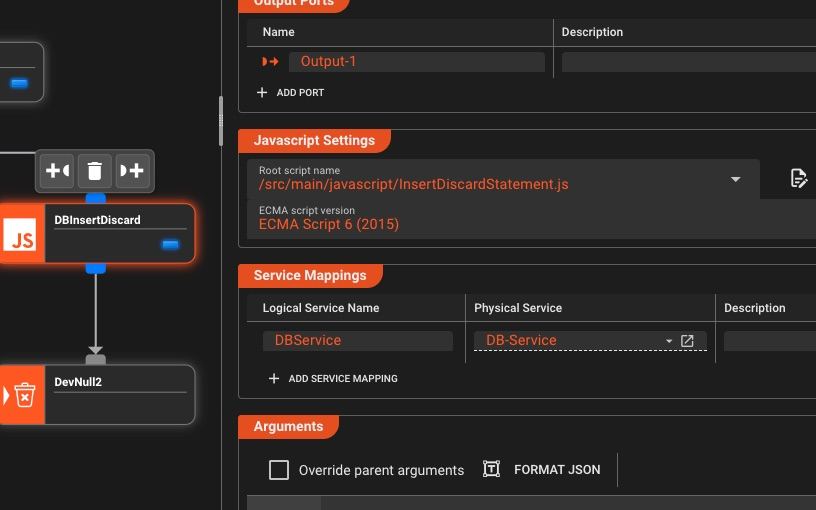
Costruito per Condutture del mondo reale
Tutto ciò di cui hai bisogno per creare, distribuire e monitorare pipeline di dati di livello produttivo
Sviluppo del flusso di lavoro visivo
Costruisci pipeline complesse con la semplicità del drag-and-drop
Canvas drag-and-drop intuitivo
Crea flussi di lavoro visivamente collegando i processori: accelera lo sviluppo con la configurazione senza codice e inserisci script personalizzati quando necessario
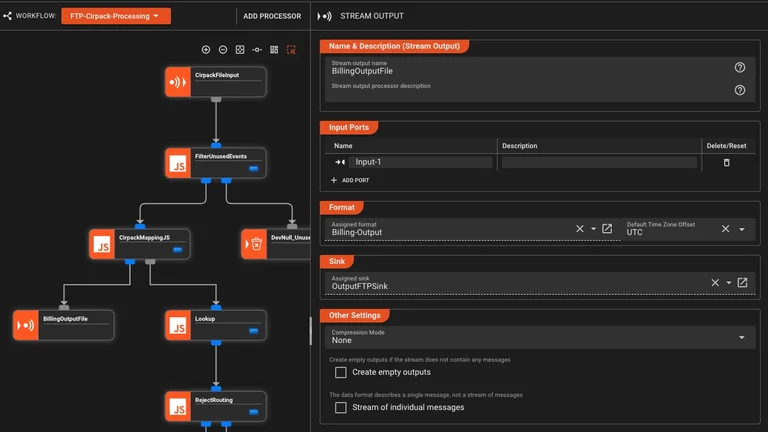
Convalida in tempo reale
Rileva gli errori di configurazione durante la creazione, prima della distribuzione
- Controllo istantaneo della sintassi
- Convalida dello schema
- Rilevamento delle dipendenze
- Evidenziazione dell'errore
Controllo della versione pronto
Configurazioni archiviate come JSON e script: traccia modifiche, ramificazioni, unione con qualsiasi sistema di controllo della versione
Assets riutilizzabili
Crea componenti modulari e riutilizzabili che possono essere utilizzati come processori o referenziati da altri processori: costruisci una volta, utilizzali ovunque
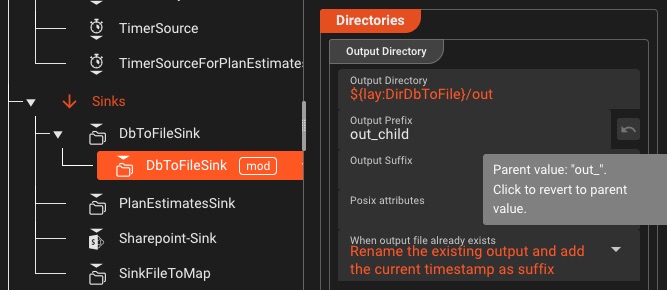
- Eredità degli Asset per una facile manutenzione
- Derivare Assets l'uno dall'altro
- Condiviso tra flussi di lavoro e progetti
Modelli personalizzati
Crea i tuoi modelli di flusso di lavoro e condividili tra progetti e team
- Salva i flussi di lavoro come modelli riutilizzabili
- Condividi tra progetti e team
- Esporta interi progetti o parti per il riutilizzo
Crea una volta, distribuisci ovunque, in ambienti e team diversi
Debug collegato al browser
Collega il debugger del tuo browser al codice Python o JavaScript e sfrutta tutta la potenza dei moderni strumenti di sviluppo
- Esecuzione passo-passo e punti di interruzione condizionali
- Osserva espressioni, ambiti e stack di chiamate
- Ispezione dei messaggi in ogni fase con variabili live
- Tracce dello stack degli errori con il mapping dell'origine
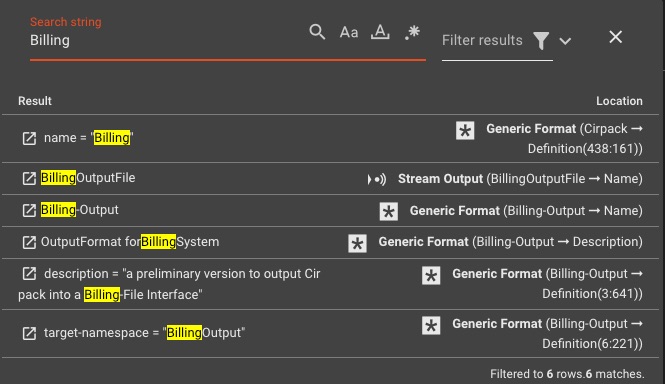
Ricerca e navigazione del flusso di lavoro
Trova e naviga rapidamente tra processori, configurazioni, elementi del flusso di lavoro e script
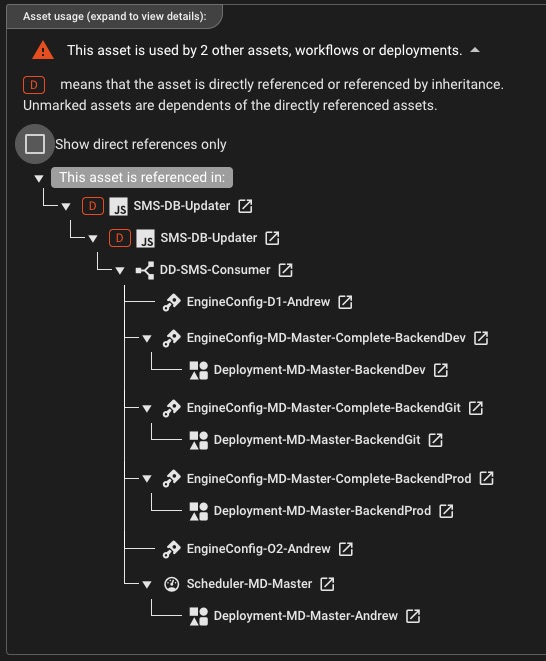
Visualizzazione della dipendenza degli Asset
Comprendi come gli Assets, i flussi di lavoro e le distribuzioni sono collegati nel tuo progetto
Collaborazione di squadra
Condividi i flussi di lavoro e collabora con il controllo degli accessi basato sui ruoli
- Controllo degli accessi granulare
- Modifica simultanea del progetto
- Notifiche di modifica del progetto
Connettività dati universale
Supporto del protocollo universale per qualsiasi origine e destinazione dati
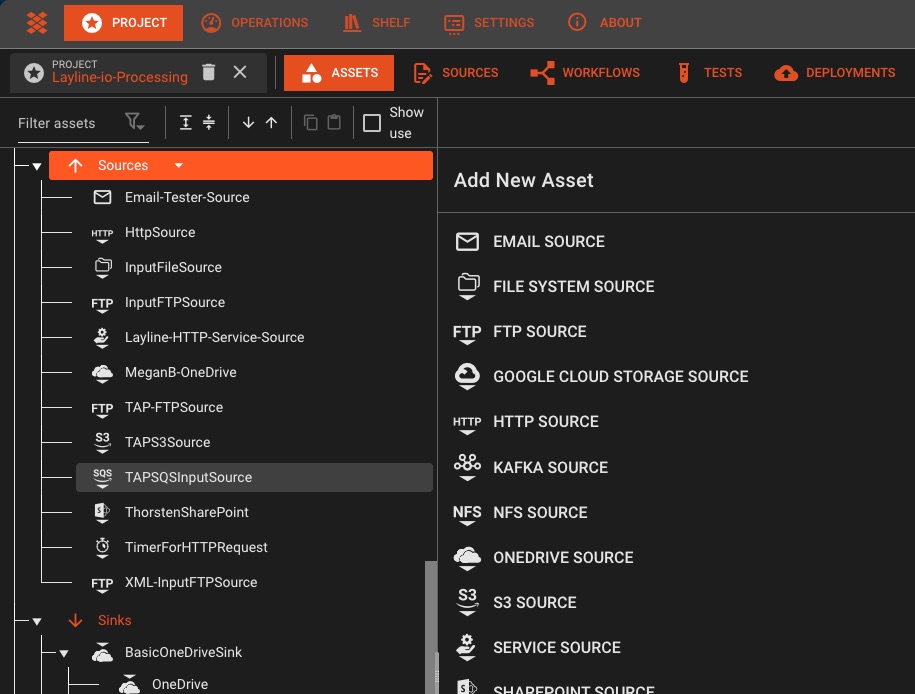
Piattaforme di streaming
Kafka, AWS SQS e SNS, UDP, Azure Hub eventi e altro ancora, il tutto con supporto nativo
- • Gruppi di consumatori
- • Semantica esattamente una volta
- • Elaborazione batch
- • Kinesis Data Streams
- • Messaggi SQS e SNS
- • S3 notifiche di eventi
Connettori di database
Leggi e scrivi su qualsiasi database con il supporto per l'acquisizione dei dati di modifica
- PostgreSQL, MySQL, SQL Server
- MongoDB, Cassandra, Redis
- Elasticsearch, DynamoDB
- AWS Keyspaces
- Hazelcast
- GCS
- Sharepoint
- Di più...
Change Data Capture
Debezium Source Asset integrato per pipeline CDC affidabili e osservabili
- CDC basato su Debezium
- Gestione nativa della backpressure e retry unificato
- Progettazione visiva delle pipeline con CDC come cittadino di prima classe
REST APIs & Webhook
Chiama qualsiasi endpoint HTTP con tentativi integrati, interruzione del circuito e autenticazione
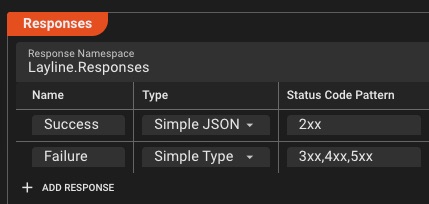
- Tasti OAuth 2.0, API, JWT
- GraphQL interrogazioni
Servizi nativi del cloud
Profonda integrazione con AWS, Azure e Google Cloud
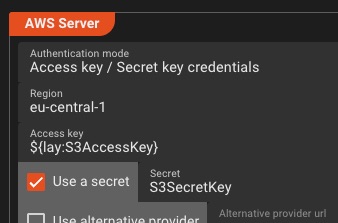
- S3, Azure Blob, GCS
- SNS/SQS, Service Bus
- CloudWatch & App Insights
- IAM e identità gestite
Enterprise Condivisione file
Accedi alle condivisioni di file aziendali e ai repository di documenti cloud
- SMB/CIFS condivisioni di rete
- NFS (File system di rete)
- WebDAV supporto protocollo
- Astrazione del file system virtuale
Microsoft 365 Integrazione
Profonda integrazione con SharePoint, OneDrive e Microsoft Graph API per la collaborazione aziendale
Protocolli di rete
Accesso alla rete di basso livello per protocolli personalizzati e streaming di dati in tempo reale
- TCP/UDP supporto sorgente e sink
- Gestione delle prese grezze
- Implementazione del protocollo personalizzato
- Streaming di dati binari
Integrazione della posta elettronica
Attiva flussi di lavoro dalle e-mail e invia notifiche con allegati
- IMAP/POP3 origini email
- SMTP consegna della posta elettronica
- Elaborazione degli allegati
- Monitoraggio di più caselle di posta
Timer e sorgenti programmate
Attiva flussi di lavoro in base a pianificazioni, finestre temporali o intervalli ricorrenti per l'elaborazione batch e attività periodiche
Modelli di pianificazione complessi con supporto completo di cron
Attivazione semplice basata su intervalli da secondi a mesi
Definire finestre temporali specifiche per l'elaborazione batch
File system e protocolli legacy
Elabora file da unità locali, condivisioni di rete, server FTP/SFTP o archiviazione cloud, con polling automatico, corrispondenza di modelli e spostamento dopo l'elaborazione
Formati e analisi dei dati
Analizza qualsiasi formato da JSON ai protocolli di telecomunicazione legacy
Formati standard
Supporto nativo per i formati dati che già utilizzi
- ASN.1
- XML
- CSV, TSV, file delimitati
- Qualsiasi formato strutturato ASCII, binario o misto
- Record a larghezza fissa
Configurazione del formato universale
Definisci qualsiasi formato dati personalizzato (CSV, gerarchico ASCII, binario o strutture miste) con un potente linguaggio di configurazione basato sulla grammatica
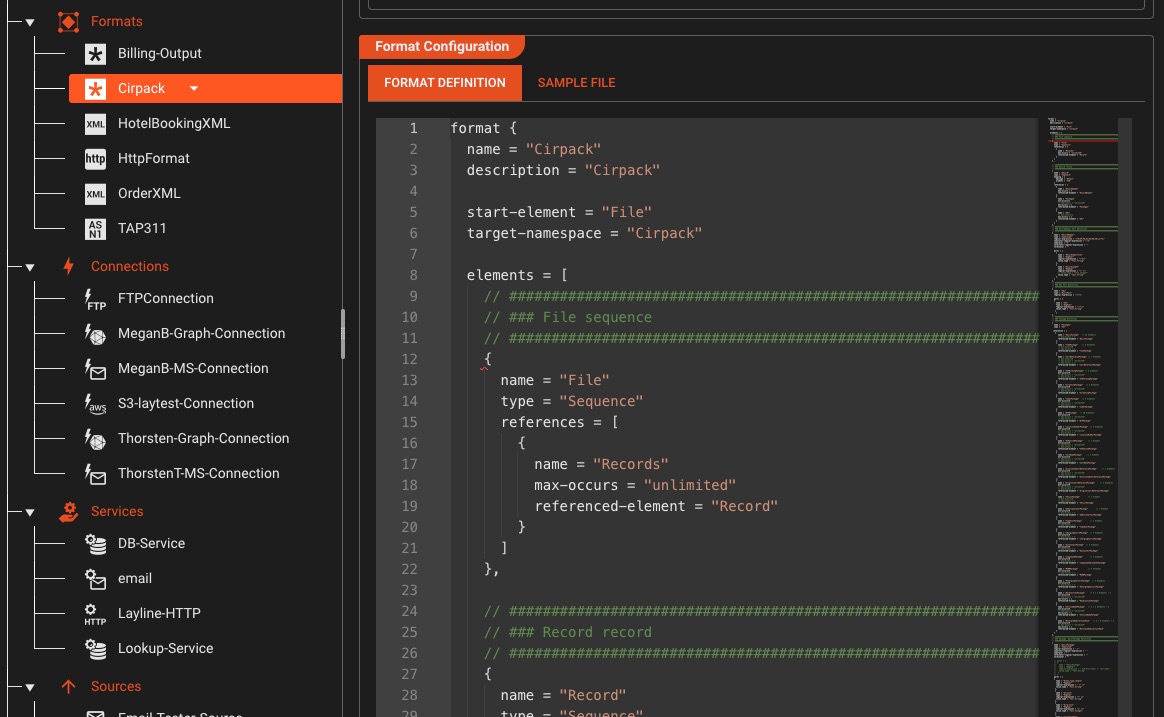
Definire i formati utilizzando espressioni regolari e strutture gerarchiche
Carica file di esempio e verifica la tua grammatica in tempo reale
Utilizza la stessa grammatica sia per analizzare l'input che per generare l'output
Convalida della sintassi in tempo reale ed evidenziazione degli errori nell'editor
ASN.1 & Protocolli di telecomunicazione
Capacità unicaAnalisi ASN.1 leader del settore per le telecomunicazioni CDRs, SS7, TCAP, MAP e protocolli legacy: funzionalità che non troverai negli strumenti generici ETL
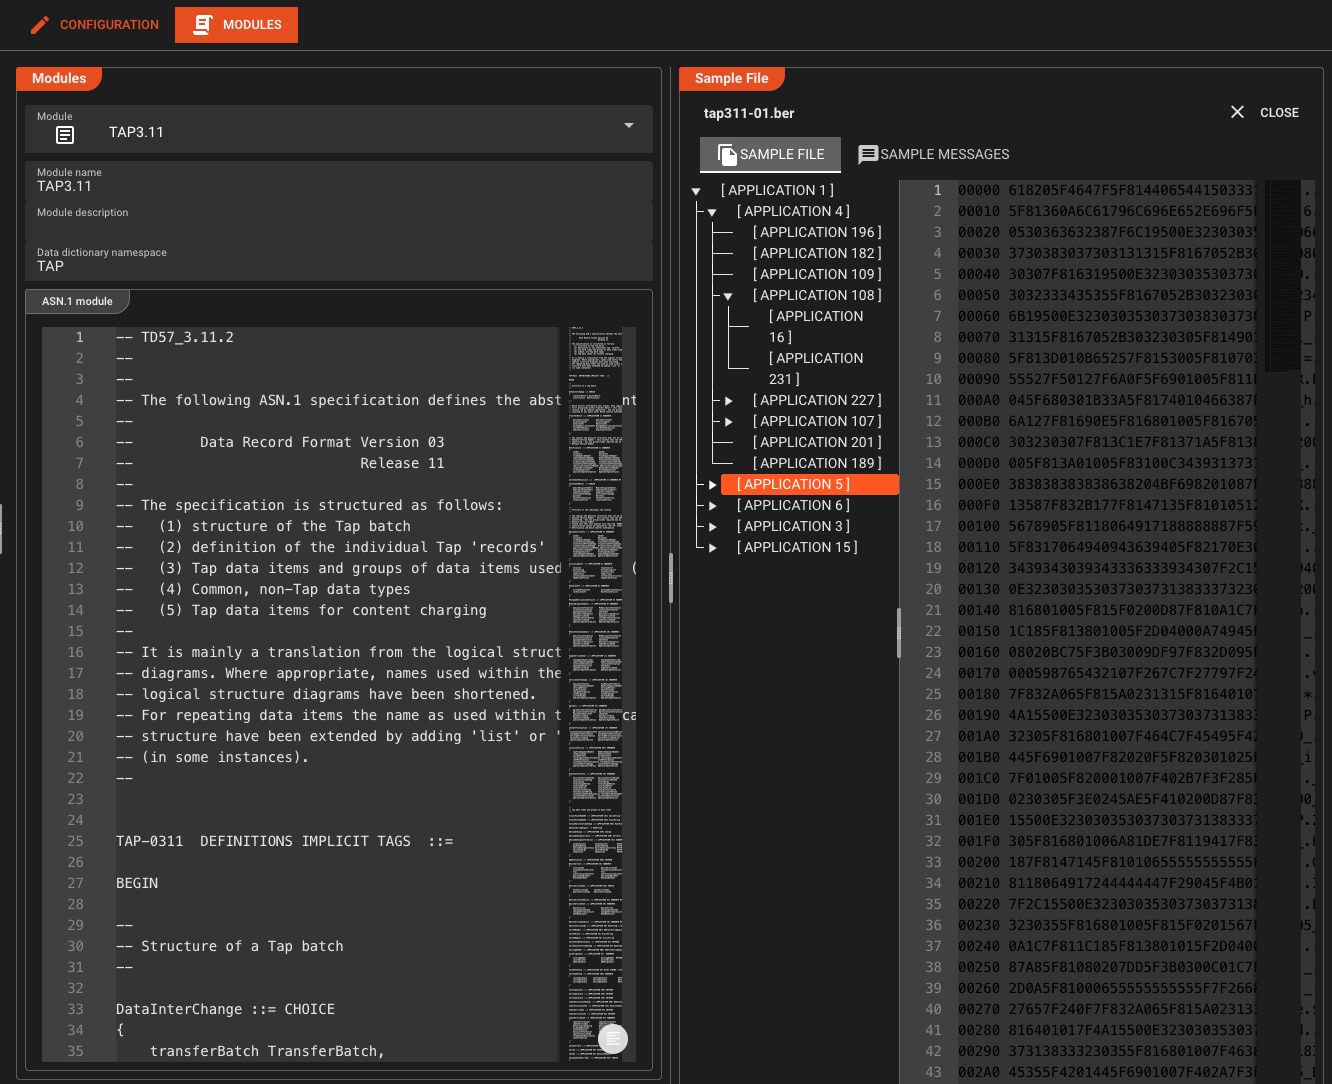
Standard supportati
Caso d'uso: Elabora miliardi di telecomunicazioni CDRs ogni giorno con analisi inferiori al millisecondo
Data Dictionary
Digitare SistemaDefinisci strutture e tipi di dati personalizzati che possono essere riutilizzati nei tuoi flussi di lavoro, con il supporto completo per la codifica/decodifica in formati esterni come JSON
Tipi personalizzati
Definire sequenze, array, enumerazioni, scelte e spazi dei nomi
Tipo Riutilizzabilità
Tipi di riferimento tra formati e flussi di lavoro per coerenza
Aumento dei messaggi
Aggiungi dati derivati o arricchiti ai messaggi in fase di esecuzione
Integrazione dei formati
Tipi di riferimento da qualsiasi formato: generico, ASN.1 o altri Data Dictionaries
Trasformazione del formato
Applica trasformazioni per convertire tra qualsiasi formato
- Mappatura e ristrutturazione del campo
- Conversioni del tipo di dati
Formati binari personalizzati
Definisci i tuoi parser di struttura binaria con precisione
- Estrazione di campi a livello di bit
- Strutture nidificate
- Analisi condizionale
Convalida e qualità
Cattura i dati non validi prima che danneggino la tua pipeline
- Convalida dello schema
- Regole di convalida personalizzate
- Arricchimento degli errori
Elaborazione del formato nativo
Cambio di giocoA differenza dei tradizionali strumenti ETL che costringono a mappare formati esterni su schemi interni fissi e viceversa, layline.io funziona direttamente con i dati nel loro formato nativo, eliminando inutili spese di trasformazione
Sistemi tradizionali ETL
- •Mappa il formato esterno sullo schema interno fisso in lettura
- •Elaborare i dati nella rappresentazione interna generica
- •Riporta lo schema interno al formato di destinazione in scrittura
- •Doppio sovraccarico e complessità della trasformazione
layline.io Avvicinamento
- Analizza i dati direttamente nella struttura del formato nativo
- Lavora con i dati nella loro struttura originale ovunque
- Data Dictionary creato dinamicamente dai tuoi formati
- Estendi con strutture personalizzate secondo necessità, senza mappatura
Perché questo è importante
Logica aziendale e trasformazione
Incorpora logica personalizzata per arricchimento, routing e trasformazioni complesse
Gestione degli errori e riprova
Gestisci gli errori con garbo con policy di tentativi configurabili e code di messaggi non recapitabili
- Criteri di ripetizione configurabili
- Strategie di backoff esponenziale
- Instradamento delle code di messaggi non recapitabili
- Modelli di interruttori automatici
- Categorizzazione degli errori
JavaScript & Python Script
Incorpora il codice personalizzato direttamente nei tuoi flussi di lavoro: supporto linguistico completo, sandbox non limitato
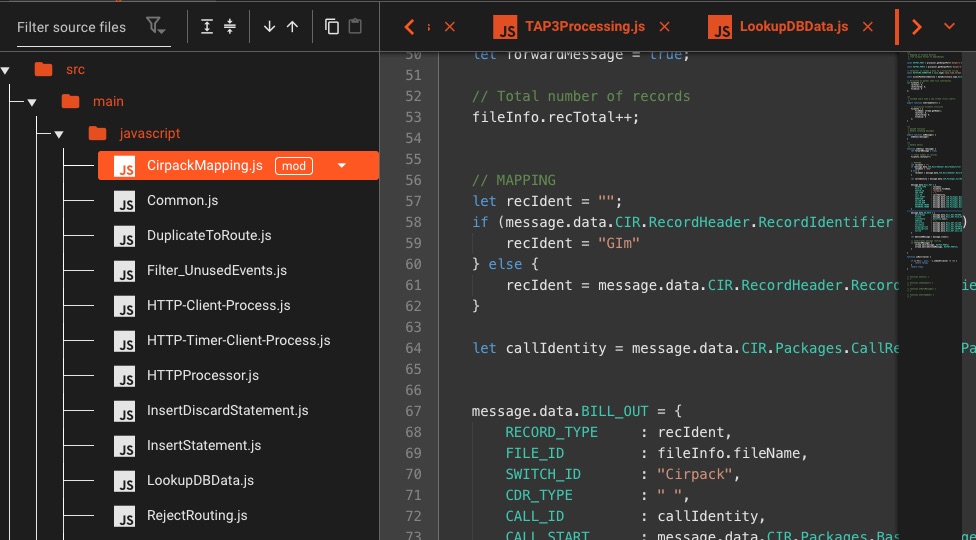
💡 Puoi anche utilizzare il tuo IDE preferito per scopi di scripting
- Asincrono/attendono supporto
- Importazioni/esportazioni
- Ganci del ciclo di vita
- Utilizzare Javascript/Python in modo intercambiabile
Mappatura dei campi
Trasforma e mappa i campi dati tra diversi formati e schemi
- Mappatore del campo visivo
- Accesso ai campi nidificati
- Mappature condizionali
- Tipo coercizione
- Gestione dei valori predefiniti
Arricchimento dei dati
Aumenta gli eventi con dati esterni da APIs, database o cache
- Accedi alle fonti di servizio ovunque all'interno della pipeline
Routing e filtraggio
Definisci le tue regole con condizioni individuali: un processore molto flessibile adatto alla maggior parte, se non a tutti, i casi di routing e filtraggio. Se ciò non fosse sufficiente, puoi sempre ricorrere allo scripting.
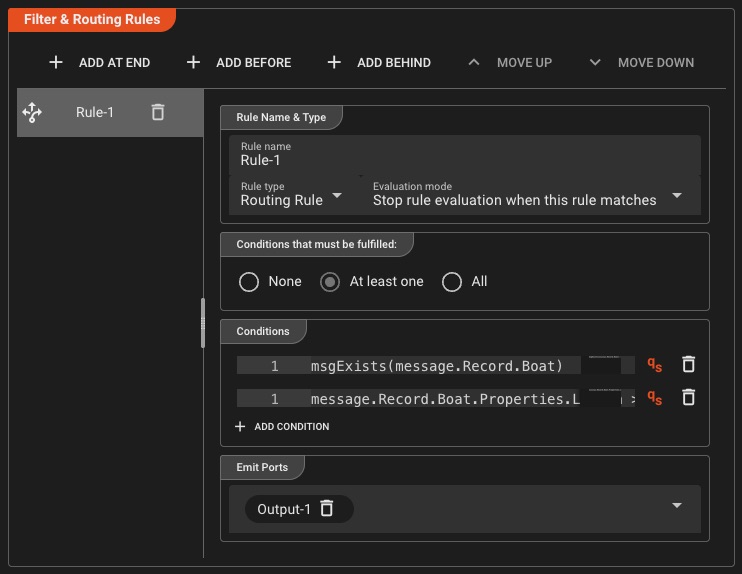
Routing basato su regole
- Definire più condizioni per regola
- Routing multidirezionale verso porte diverse
- Combinazioni di condizioni AND/OR
Filtraggio flessibile
- Regole di filtraggio basate sul contenuto
- Confronti dei valori di campo
- Fallback allo scripting quando necessario
Limitazione e limitazione della velocità
Controlla il flusso dei messaggi e previeni il sovraccarico del sistema con la limitazione intelligente
- Controllo della velocità dei messaggi
- Gestione di backpressure
- Gestione dello scoppio
- Throttling dinamico
Elaborazione con stato
Mantieni lo stato tra gli eventi per flussi di lavoro complessi
- Archivi di stato in memoria
- Backend di stato persistenti
- Garanzie "exactly-once".
- Checkpoint e recupero
- Sicurezza transazionale
Tieni traccia delle sessioni utente, conta gli eventi o mantieni i totali parziali su milioni di flussi
Aggregazione e finestre temporali
Elabora i flussi con finestre a cascata, scorrevoli o di sessione per analisi in tempo reale
Finestre cadenti
Intervalli di tempo di dimensione fissa e non sovrapposti
Ogni 5 minutiFinestre scorrevoli
Finestre sovrapposte per le medie mobili
Finestra di 10 minuti, diapositiva di 1 minutoFinestre di sessione
Raggruppamento basato sull'attività con timeout
Intervallo di inattività di 30 secondiFlessibilità illimitata
Utilizzando JavaScript o Python, è possibile definire qualsiasi tipo di logica di elaborazione basata sui messaggi che fluiscono attraverso i processori. Concatena uno o più processori per implementare sistemi completi: rilevamento delle frodi, calcolo dei prezzi, filtraggio, trasformazione o qualsiasi altra cosa ti venga in mente. Arricchisci i dati provenienti da fonti esterne, dirama e instrada verso destinazioni specifiche in base alla tua logica aziendale. Puoi anche usare il tuo IDE invece di fare affidamento su Configuration Center per scrivere i tuoi script.
Rilevamento delle frodi
Analizza i modelli di transazione in tempo reale per identificare e bloccare attività fraudolente
Prezzi dinamici
Calcola i prezzi al volo in base alla domanda, all'inventario e alle condizioni di mercato
Trasformazione dei dati
Filtra, rimodella e arricchisci i dati provenienti da più fonti in formati unificati
Analisi in tempo reale
Aggrega e calcola le metriche dei dati in streaming per ottenere informazioni immediate
Avvisi intelligenti
Rileva anomalie e attiva notifiche in base a regole aziendali personalizzate
Orchestrazione di eventi
Coordina flussi di lavoro complessi in più fasi su sistemi distribuiti
Questi sono solo esempi. Il sistema non si limita a questi casi d'uso: implementa tutto ciò di cui la tua azienda ha bisogno con il supporto completo del linguaggio di programmazione e gli hook del ciclo di vita per flussi, transazioni e messaggi.
Distribuzione e orchestrazione
Distribuisci ovunque: cloud, edge o on-premise con aggiornamenti senza tempi di inattività
Distribuzione del cluster con un clic
Distribuisci su qualsiasi cluster con un solo clic: nessuna riga di comando, nessuna configurazione complessa, solo una gestione visiva intuitiva della distribuzione
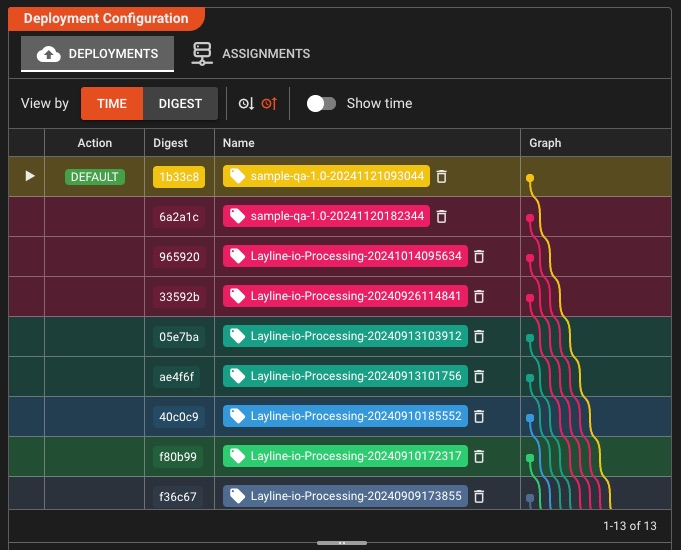
Distribuzione semplificata
- Distribuzione con un clic su qualsiasi cluster
- Propagazione automatica delle configurazioni a livello di cluster
- Non sono necessarie righe di comando o configurazioni complesse
- Guida visiva alla distribuzione
- Assegnare distribuzioni a nodi cluster specifici
Gestione delle versioni
- Cronologia completa della distribuzione archiviata nel cluster
- Passaggio continuo e senza tempi di inattività tra le versioni
- Rollback istantaneo a qualsiasi distribuzione precedente
- Aggiornamenti incrementali alle distribuzioni esistenti
Docker Contenitori
Creare pacchetti di flussi di lavoro come contenitori leggeri
- Docker Compose supporto
- Immagini multi-arcata (x86/ARM)
- Immagini di base minime
Mesh multiregione
Cluster geo-distribuiti con failover automatico
- Replica tra regioni
- Failover automatico
- Bilanciamento del carico
- Località dei dati
Enterprise: Distribuisci in tutti i continenti con una latenza di sincronizzazione <10ms
CI/CD Integrazione della pipeline
Distribuisci dalla CLI con automazione tramite script per un'integrazione perfetta CI/CD
- Distribuzioni a comando singolo con flag
- Possibilità di scripting tramite shell per l'automazione
- Codici di uscita per l'integrazione della pipeline
Configurazioni di distribuzione granulare
Crea una volta, configurane molti: crea composizioni di distribuzione riutilizzabili su misura per ciascun ambiente senza duplicare i flussi di lavoro
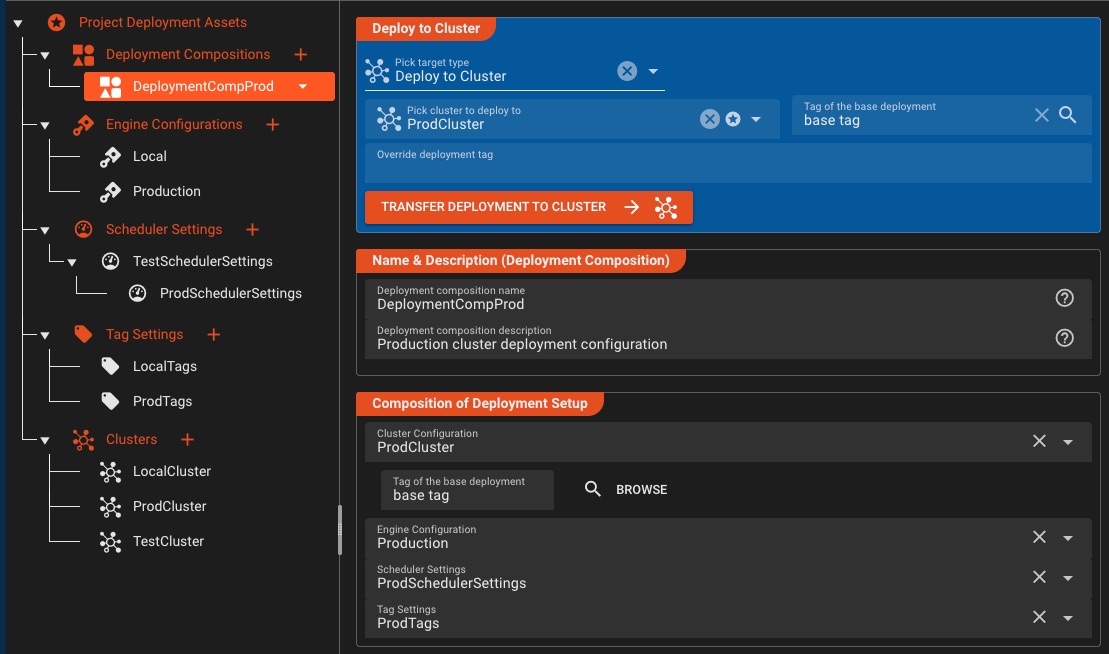
Configurazioni componibili
- Configurazioni del motore per ambiente
- Impostazioni dello scheduler per il controllo delle istanze
- Impostazioni dei tag per il targeting della distribuzione
- Le composizioni di distribuzione combinano tutte le configurazioni
Flessibilità dell'ambiente
- Sostituisci i segreti per ambiente
- Sostituisce la variabile specifica dell'ambiente
- Scegli il cluster di destinazione su richiesta
- Gestisci le configurazioni di test, sviluppo e produzione in modo indipendente
Distribuisci con precisione: Combina e abbina configurazioni del motore, impostazioni dello scheduler e configurazioni dei tag per creare composizioni di distribuzione che si adattino perfettamente a ciascun ambiente, senza duplicazione del flusso di lavoro.
Pianificazione dinamica del flusso di lavoro
Scala le istanze del flusso di lavoro on-demand e distribuisci la potenza di elaborazione in modo intelligente nel tuo cluster
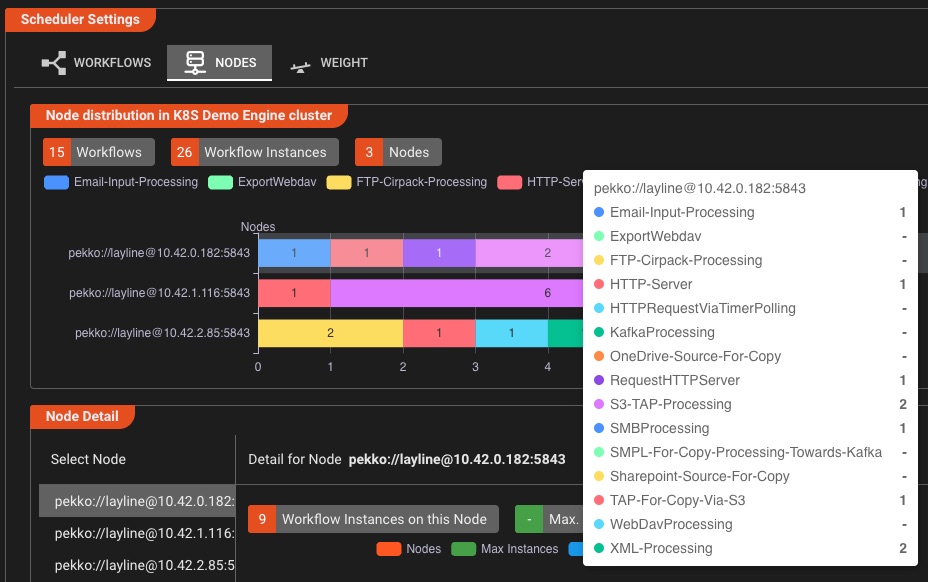
Scalabilità intelligente
- Regola le istanze del flusso di lavoro con un solo clic
- Definire i limiti minimi/massimi dell'istanza
- Imposta la priorità della potenza di elaborazione per flusso di lavoro
- Scalabilità in tempo reale senza tempi di inattività
Distribuzione dei cluster
- Visualizza la distribuzione del carico tra i nodi
- Aggiungi i flussi di lavoro a nodi cluster specifici
- Bilancia automaticamente i carichi di lavoro
- Monitora la distribuzione delle istanze in tempo reale
Scala con sicurezza: Aumenta o riduci al volo le istanze del flusso di lavoro, assegna carichi di lavoro specifici a nodi dedicati e ottimizza l'allocazione della potenza di elaborazione, il tutto da un'interfaccia visiva intuitiva.
Enterprise Sicurezza e crittografia
Sicurezza Zero Trust con crittografia a chiave pubblica-privata: proteggi i segreti dagli sviluppatori mantenendo un accesso sicuro
- Crittografia a chiave pubblica-privata
- Archiviazione di sicurezza centralizzata
- Identità e certificati affidabili
- Accesso segreto basato sui ruoli
- Autenticazione del sistema di terze parti
- Di più...
Zero Trust fin dalla progettazione: Solo chi dispone di chiavi private può decrittografare i segreti: gli sviluppatori rimangono produttivi senza esporre credenziali sensibili.
Aggiornamenti senza tempi di inattività e cambio di versione istantaneo
Aggiorna i flussi di lavoro in esecuzione senza eliminare un singolo evento: il cluster conserva tutte le versioni di distribuzione, passa a qualsiasi versione con un clic
Cambio di versione
Cluster memorizza tutte le versioni: passa a qualsiasi versione con un clic
Rilasci delle Canarie
Instrada il 5% del traffico per testarlo prima del lancio completo
Rollback istantaneo
Torna alla versione precedente in <1 secondo
Controlli sanitari
Convalida automatica prima del cambio di traffico
Osservabilità e debug
Visibilità completa sulle pipeline di dati con monitoraggio e debug in tempo reale
Dashboard di monitoraggio in tempo reale
Metriche delle prestazioni in tempo reale e approfondimenti visivi per ogni flusso di lavoro
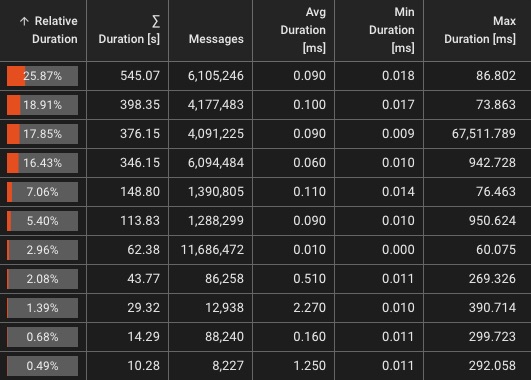
Metriche in tempo reale
- Throughput (eventi/sec)
- Tassi e tipi di errore
- Metriche dei messaggi
Visualizzazioni
- Distribuzione del carico del flusso di lavoro
- Diagrammi di flusso in tempo reale
- Velocità effettiva per processore
Message Sniffing
Ispeziona i dati in tempo reale che fluiscono attraverso le tue pipeline
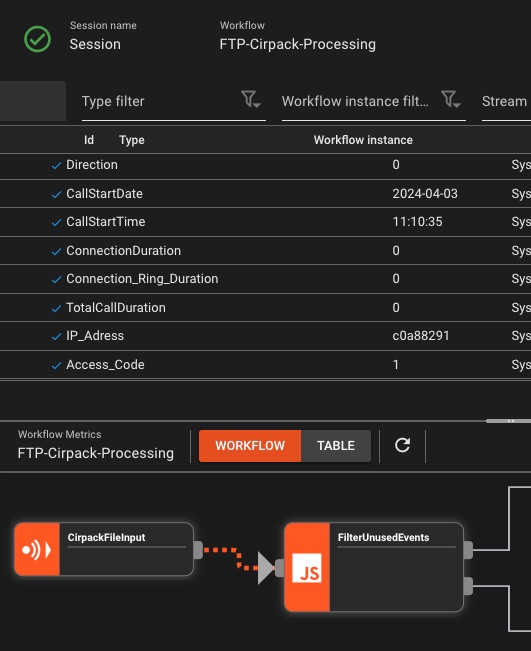
- Acquisizione dei messaggi in tempo reale
- Filtra per contenuto/metadati
- Display compatibile con il formato
- Esporta campioni
Suggerimento da professionista: Sniffa qualsiasi processore per vedere le trasformazioni in azione
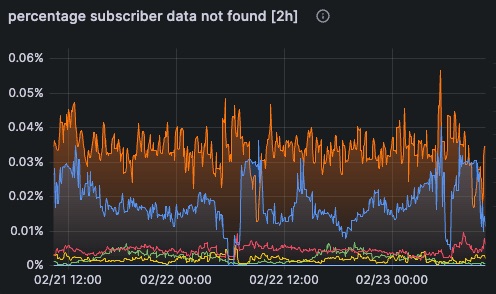
Prometheus Metriche e OpenTelemetry
Osservabilità standard del settore che si integra con lo stack esistente
Ispettore dello stato del motore live
Esegui il drill-down dal cluster alle porte dei singoli processori: scopri esattamente cosa è distribuito e in esecuzione, senza file di origine
- Visualizzazione della distribuzione gerarchica
- Distribuzione del flusso di lavoro al nodo
- Conteggio istanze per nodo
- Ispezione dello stato a livello di processore
- Visibilità della configurazione
- Stato della connessione e del servizio
Trasparenza della produzione: Controlla cosa è effettivamente in esecuzione in produzione, dai flussi di lavoro fino alle singole porte, anche senza file sorgente del progetto. Perfetto per la risoluzione dei problemi e la verifica della distribuzione.
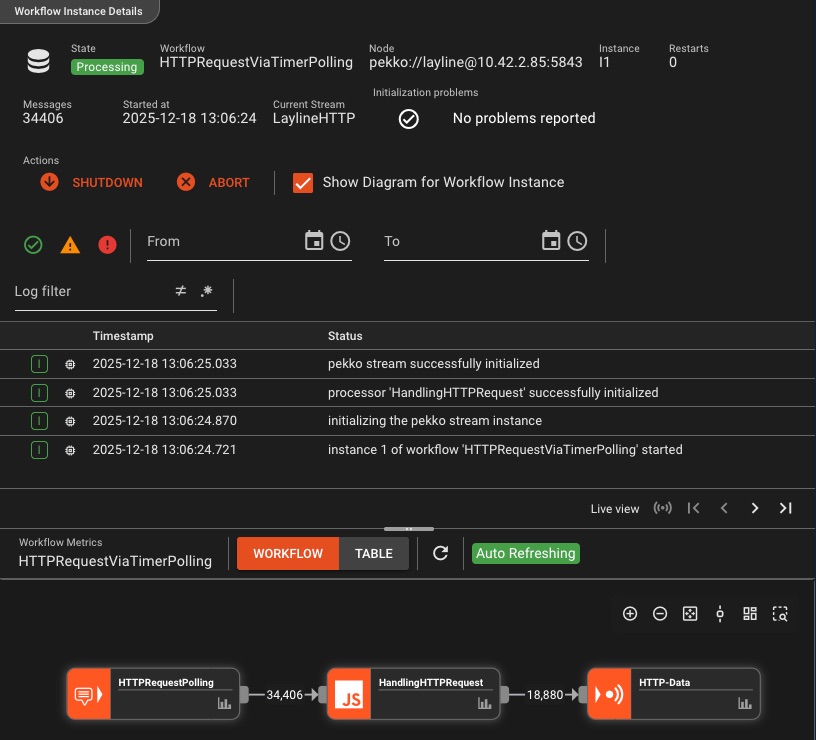
Registrazione completa e traccia di controllo
Ogni azione, ogni evento, ogni errore: completamente registrato e tracciabile con visibilità granulare per istanza
Visibilità granulare
- Registrazione dell'istanza per flusso di lavoro
- Dettagli di esecuzione a livello di flusso
- Stato e monitoraggio dello stato
- Contesto dell'errore e analisi dello stack
Controllo e personalizzazione
- Messaggi di registrazione personalizzati
- Avvia/arresta istanze del flusso di lavoro
- Filtra per gravità e origine
- Cronologia completa degli audit
Non perdere mai il contesto: Dall'inizializzazione allo spegnimento, ogni azione del flusso di lavoro viene registrata con timestamp precisi, consentendo una rapida risoluzione dei problemi e una completa trasparenza operativa.
Debug di script live in produzione
Eseguire il debug dei flussi di lavoro in esecuzione su qualsiasi nodo del cluster con punti di interruzione, esecuzione passo-passo e manipolazione delle variabili di runtime, proprio come DevTools del tuo browser
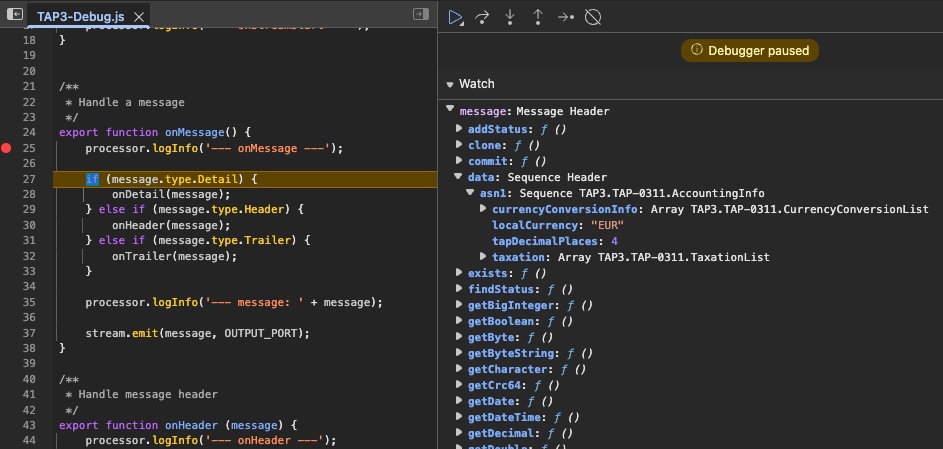
Debug interattivo
- Imposta punti di interruzione in qualsiasi script
- Scorri il codice riga per riga
- Sospendere il flusso di lavoro al punto di interruzione
- Riprendi o entra nelle funzioni
Ispezione e manipolazione del runtime
- Ispeziona tutte le variabili e i dati dei messaggi
- Modificare i valori in fase di esecuzione
- Testa i casi limite al volo
- Debug su qualsiasi nodo del cluster
Debug a livello di produzione: Collegati a flussi di lavoro in tempo reale, imposta punti di interruzione e ispeziona i messaggi reali mentre fluiscono attraverso la tua pipeline, senza ridistribuzione. Modifica le variabili al volo per testare istantaneamente le correzioni.
Test delle funzioni del servizio interattivo
Testare le funzioni del servizio in modo isolato: eseguire query sul database, inviare e-mail o chiamare APIs direttamente dal dashboard senza eseguire flussi di lavoro
- Esegui funzioni in modo interattivo
- Compila i parametri al volo
- Convalida immediata dei risultati
- Testare le query DB in tempo reale
- Convalidare qualsiasi funzione del servizio
- Nessun flusso di lavoro richiesto
Effettua test più intelligenti, non più difficili: Perché ricostruire e ridistribuire interi flussi di lavoro solo per verificare una query di database o qualsiasi altra funzione del servizio? Testa il funzionamento del servizio in modo indipendente, esegui l'iterazione rapidamente e spedisci con sicurezza.
Avvisi e notifiche intelligenti
Ricevi una notifica quando le cose vanno male, prima che i tuoi utenti se ne accorgano
Avvisi di soglia
Trigger su latenza, tasso di errore, anomalie di throughput
Integrità del flusso di lavoro
Stato del flusso, errori delle istanze, disponibilità dei nodi
Bersagli dinamici
Definisci al volo gli obiettivi dell'allarme: email, Teams, ecc.
Regole di avviso personalizzate
Crea modelli, regole e gruppi target
Si integra con La tua pila
Integrazione basata su standard con strumenti e protocolli diffusi
Esplorare Ulteriore
Scopri di più sui casi d'uso, sui prezzi e su come layline.io soddisfa le tue esigenze
Panoramica del prodotto
Scopri l'architettura reattiva, le funzionalità della piattaforma e le basi tecniche di layline.io
Saperne di piùSoluzioni per l'industria
Scopri come i team dei settori finanziario, delle telecomunicazioni, dell'e-commerce e altro ancora utilizzano layline.io
Esplora le soluzioniPerchè layline.io?
Confronta layline.io con altre piattaforme e scopri come ci confrontiamo
Vedi ConfrontoPronto per iniziare?
Prova Community Edition gratuitamente o programma una demo con il nostro team
IniziaApprofondimenti sulle funzionalità e tutorial
Scopri come sfruttare al meglio le potenti funzionalità di layline.io
IBM possiede Confluent. Gli utenti Kafka hanno ancora un problema di runtime.
Il protocollo Kafka rimane aperto. Il centro di gravità commerciale no. Sette mesi dopo l'acquisizione di Confluent da parte di IBM, le domande che contano sono dual-run, replay e chi possiede il batch quando la storia dello streaming è watsonx.
Streamhouse è il nuovo buzzword. Ecco la parte che conta davvero.
Confluent, Aiven e Redpanda vogliono farti credere che lo streamhouse cambi tutto. Cambia alcune cose. Ma non risolve il problema con cui la maggior parte dei team sta realmente lottando.
Data Products Fail When Nobody Owns the Runtime
Teams love calling their outputs 'data products.' But renaming a dashboard doesn't make it a product. The real test is who gets paged when it breaks at 2 AM — and whether they have the authority to fix it.