Von Andrew Tan
Die Demo, die nie altert
So läuft normalerweise das Iceberg-Pitch ab:
Ein Engineer steht vor einem Bildschirm und führt eine Abfrage gegen einen Parquet-Datensatz aus. Dann führt er dieselbe Abfrage gegen eine Iceberg-Tabelle aus. Die Ergebnisse sind identisch. Das Publikum nickt. Dann zeigt er Time Travel – das Zurücksetzen auf einen vorherigen Snapshot – und der Raum murmelt tatsächlich. Jemand fragt nach Schema-Evolution. Der Engineer fügt eine Spalte hinzu, schreibt nichts um, und die alten Abfragen funktionieren weiterhin. Das Komitee ist überzeugt.
Sechs Monate später sitzt dasselbe Team in einem anderen Raum. Dieser hat keinen Bildschirm. Nur eine Tabelle, eine wachsende Liste von Alerts und eine Frage, die während der Demo niemand gestellt hat:
Wer ist für die Compaction verantwortlich?
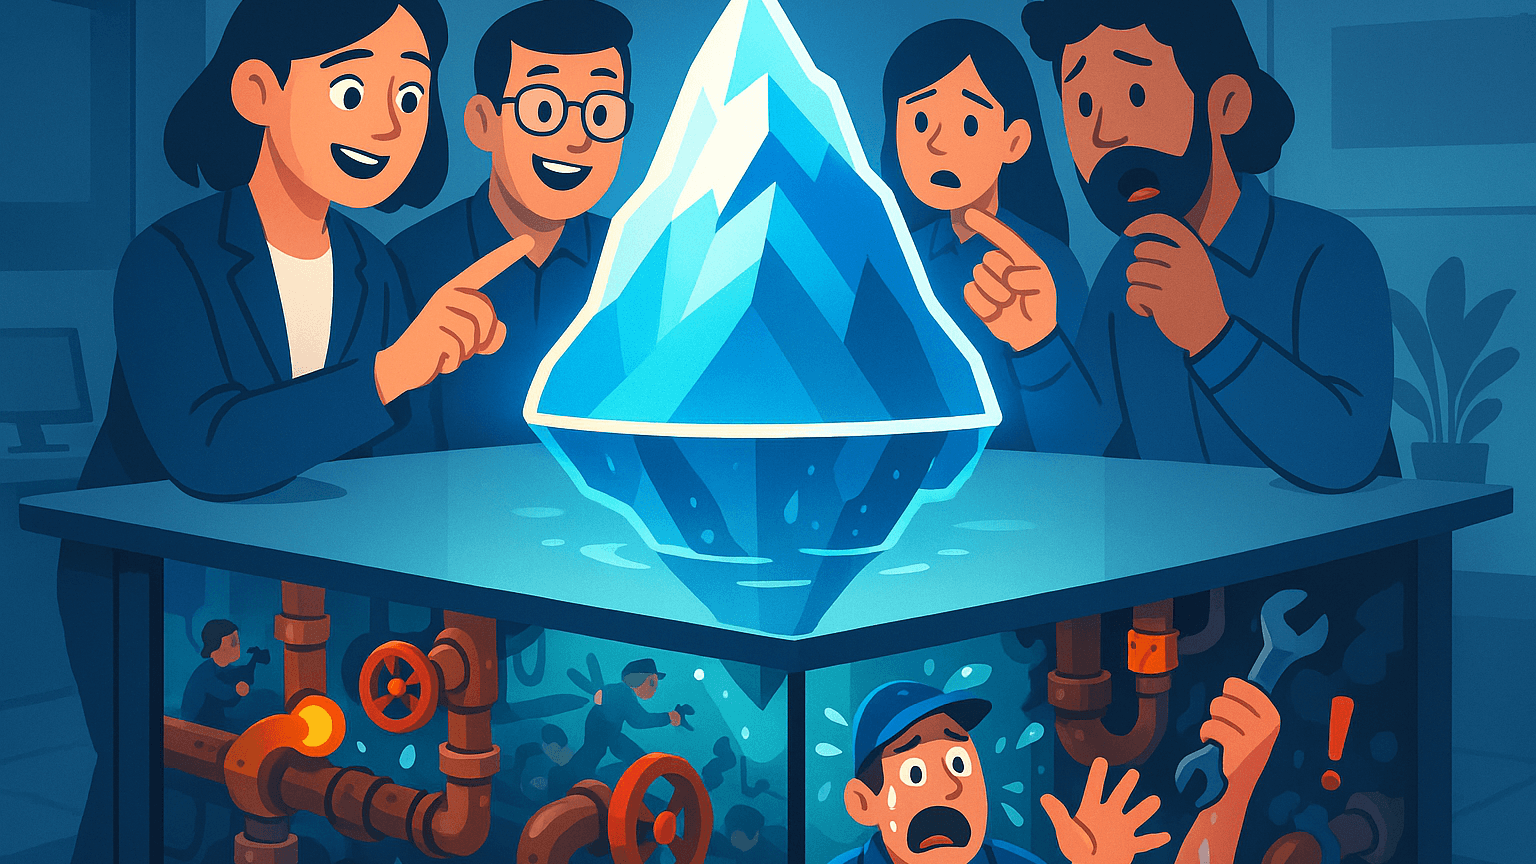
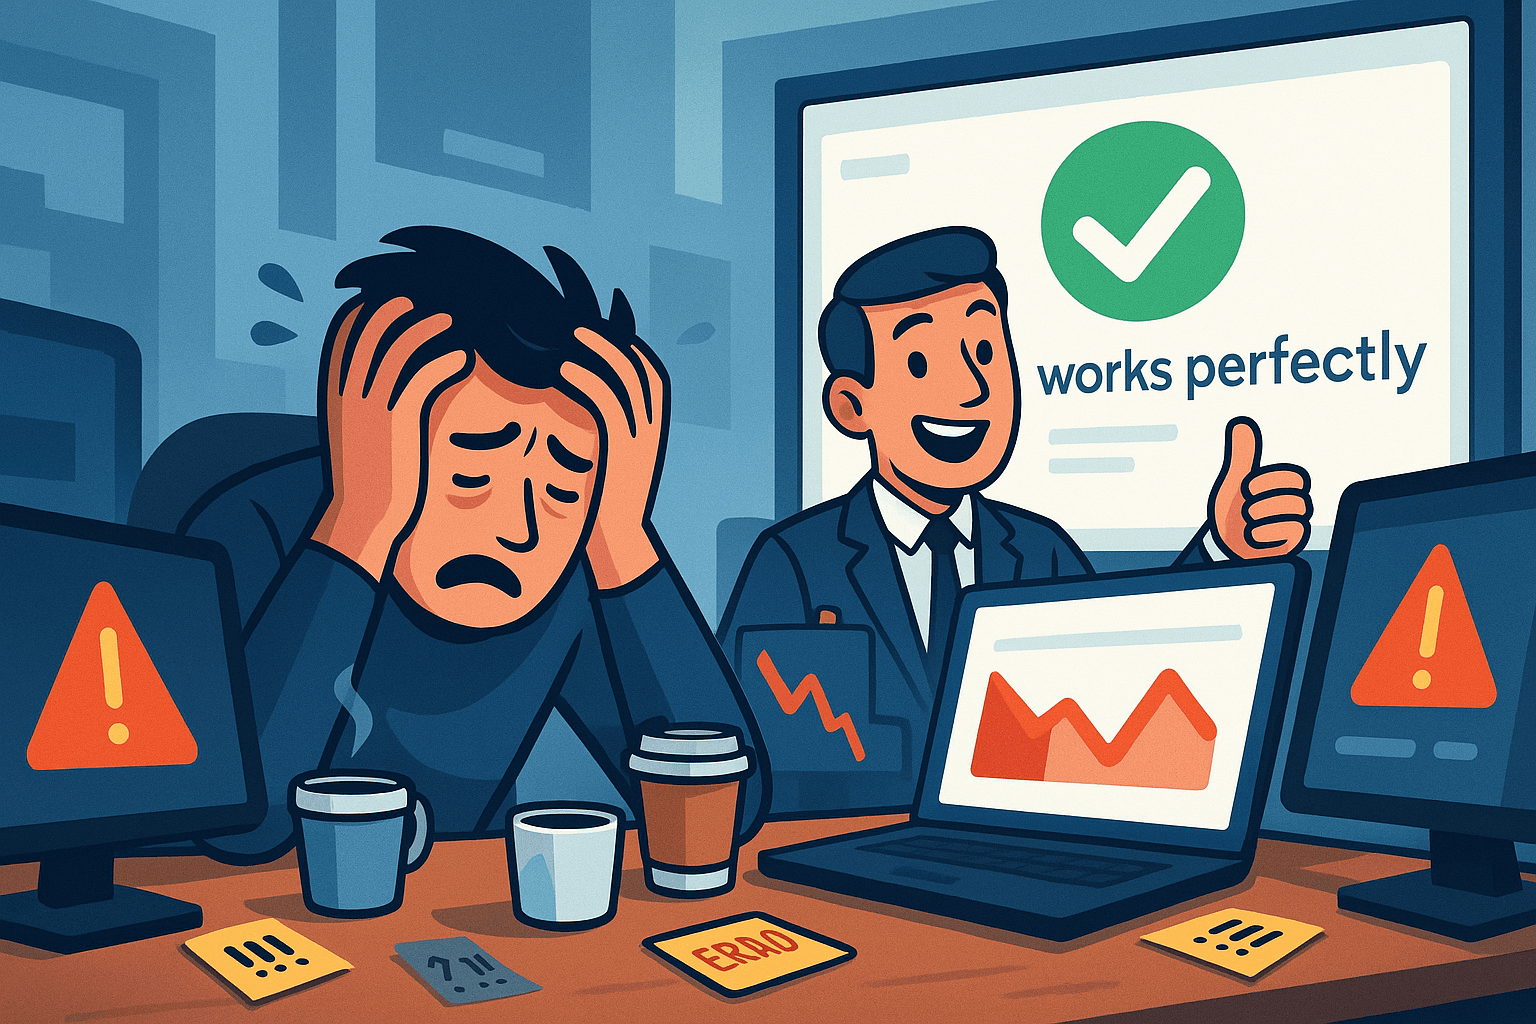
Die Demo zeigte, was Iceberg möglich macht. Sie zeigte nicht, wozu Iceberg Ihr Problem macht.
Was die Spezifikation verspricht vs. was das Team übernimmt
Offene Tabellenformate sind ein echter Fortschritt. Portabilität über Engines hinweg, Snapshot-Isolation, Partition-Evolution und Hidden Partitioning sind echte Fähigkeiten, die echte Schmerzen lösen. Wenn Sie versuchen, aus einem herstellergebundenen Warehouse auszubrechen, sind Iceberg, Delta Lake und Hudi die besten Auswege.
Aber die Spezifikation ist nicht das System. Die Spezifikation legt fest, wie die Metadaten angelegt sein sollten. Sie sagt nicht, wie Ihr Team verhindert, dass diese Metadaten unbegrenzt wachsen, wie Sie die Compaction über mehrere Writer koordinieren oder was passiert, wenn zwei verschiedene Query-Engines nicht übereinstimmen, welchen Snapshot sie lesen sollen.
Hier das, was die Demo überspringt:
Compaction ist nicht automatisch
Jedes Insert, Update und Delete erzeugt neue Dateien und neue Metadaten-Einträge. Unbeaufsichtigt sammelt eine hochfrequente Tabelle Tausende kleiner Dateien an. Die Abfrageperformance sinkt. Die Metadaten-Dateien blähen sich auf. Die Tabelle, die in der Demo schnell aussah, fängt in der Produktion an, Timeouts zu produzieren. Jemand muss die Compaction planen, überwachen, tunen und die Fehler behandeln, wenn zwei Jobs versuchen, dieselbe Partition umzuschreiben.
Katalog-Fragmentierung ist real
Iceberg-Tabellen brauchen einen Katalog: Hive, Glue, Nessie, Polaris, ein eigener REST-Service. Jeder Katalog hat sein eigenes Konsistenzmodell, seine eigene Authentifizierung, seinen eigenen Upgrade-Zyklus. Ein Team, das Iceberg annimmt, um Vendor Lock-in zu vermeiden, endet oft damit, zwei oder drei Katalogsysteme statt eines Warehouses zu betreiben. Die Bindung verlagert sich vom Speicherformat auf die Katalog-Ebene.
Retention-Policy ist ein verteiltes Problem
Wenn ein Snapshot abläuft, markiert Iceberg die Daten als unerreichbar. Aber die zugrunde liegenden Dateien existieren weiterhin im Objektspeicher, bis etwas sie löscht. Dieses „etwas“ ist Ihr Problem. Wenn Sie eine aggressive Retention einstellen, um Speicher zu sparen, verlieren Sie möglicherweise die Möglichkeit, zurückzurollen, wenn ein Downstream-Job schlechte Ergebnisse liefert. Wenn Sie alles behalten, vervielfacht sich Ihre Speicherrechnung, während Ihr S3-Bucket zu einer archäologischen Ausgrabung wird.
Batch und Streaming sehen unterschiedliche Tabellen
Ein Batch-Job, der in Iceberg schreibt, produziert große, gut strukturierte Dateien. Ein Streaming-Job produziert kleine, häufige Dateien. Wenn beide Pfade in dieselbe Tabelle schreiben, muss der Query-Planer zwei radikal unterschiedliche Dateilayouts verarbeiten. Der Streaming-Pfad braucht häufige Compaction, um lesbar zu bleiben. Der Batch-Pfad braucht stabile Dateien, um Neuberechnungen zu vermeiden. Diese beiden Rhythmen in einer Tabelle zu koordinieren ist schwieriger, als die Architekturdiagramme suggerieren.
Die Demo zeigte einen einzelnen Writer und einen einzelnen Reader. Die Produktion funktioniert selten so.
Warum „offen“ neue Fragmentierung erzeugt
Das Versprechen offener Tabellenformate ist Interoperabilität. Dieselben Daten mit Spark, Trino, Flink, DuckDB, Snowflake, BigQuery abfragen. In der Praxis unterstützt jede Engine einen anderen Teil der Spezifikation auf einem anderen Reifegrad.
Eine Engine unterstützt Position Deletes, aber keine Equality Deletes. Eine andere unterstützt Time Travel, aber nur für Tabellen, die von ihrem eigenen Katalog geschrieben wurden. Eine dritte unterstützt Partition-Evolution, erfordert aber eine bestimmte Metadatenversion, die ältere Reader bricht. Die Tabelle ist theoretisch „offen“. In der Praxis ist sie an die spezifische Kombination aus Engines und Katalogversionen gekoppelt, die Ihr Team gerade betreibt.
Das ist keine Kritik an den Projekten selbst. Iceberg, Delta und Hudi entwickeln sich schnell und verbessern sich rasant. Das Problem ist, dass Teams sie adoptieren und Befreiung erwarten, aber eine neue Art betrieblicher Oberfläche entdecken. Statt eines Anbieters, den sie verantwortlich machen können, haben sie eine Matrix von Versionskompatibilitäten zu verwalten.
Die versteckten Kosten sind kognitive Last. Ihre Data Engineers müssen jetzt nicht nur ihre Pipelines verstehen, sondern auch die Compaction-Planung, das Konsistenzmodell des Katalogs, die Metadatenformatversion und das engine-spezifische Verhalten jedes Tools, das die Tabelle berührt. Diese Expertise kommt nicht aus einer Demo.
Die Checkliste, die niemand vor der Adoption durchläuft
Wenn Ihr Team ein offenes Tabellenformat evaluiert, sind das die Fragen, die wichtiger sind als die Abfrageperformance in einem Benchmark:
Wer ist für die Compaction verantwortlich, und was passiert, wenn sie fehlschlägt?
Compaction ist keine einmalige Einrichtung. Es ist ein kontinuierlicher Hintergrundprozess, der um dieselben Computeressourcen konkurriert wie Ihre produktiven Abfragen. Wenn die Compaction zurückfällt, werden Abfragen langsamer. Wenn die Compaction eine Partition beschädigt, ist die Wiederherstellung manuell und stressig. Sie brauchen einen Verantwortlichen, ein Runbook und eine Möglichkeit, zu erkennen, wenn die Compaction nicht mithält.
Wie sieht Ihre Katalog-Exit-Strategie aus?
Kataloge sind der eigentliche Lock-in-Punkt. Wenn Sie sich heute für Glue entscheiden, können Sie später zu Nessie oder Polaris migrieren, ohne Tabellenpfade neu zu schreiben und jeden Downstream-Job neu zu konfigurieren? Die meisten Teams testen das erst, wenn sie dazu gezwungen werden.
Wie gehen Sie mit verspäteten Daten und Backfills um?
Batch-Backfills und verspätete Streaming-Daten überschreiben beide historische Partitionen. Offene Tabellenformate bewältigen das besser als reines Parquet, aber sie lösen das Koordinationsproblem nicht. Wenn ein Backfill läuft, während ein Streaming-Job in dieselbe Partition schreibt, müssen Sie die Isolationssemantik, das Retry-Verhalten und genau das Verhalten jeder Engine bei Konflikten verstehen.
Was ist Ihr Plan für das Metadatenwachstum?
Metadaten-Dateien sind klein, aber sie vervielfachen sich. Eine Tabelle mit täglichen Snapshots und stündlicher Compaction kann Tausende Metadaten-Dateien pro Monat erzeugen. Objektspeicher ist günstig, aber LIST-Operationen sind nicht kostenlos. Einige Query-Engines laden den gesamten Metadatenbaum in den Speicher. Ab einer bestimmten Größe werden die Metadaten selbst zum Performance-Engpass.
Wer wird gepaged, wenn eine Abfrage falsche Ergebnisse liefert?
Snapshot-Isolation ist großartig, bis jemand den falschen Snapshot liest, weil der Katalog kurz inkonsistent war. Oder weil ein Streaming-Job einen unvollständigen Batch committet hat. Oder weil zwei Engines dieselbe Metadaten-Datei unterschiedlich interpretiert haben. Das Debuggen dieser Probleme erfordert Expertise im Format, im Katalog und in der spezifischen Engine. Die Bereitschaftsrotation wird tiefer.
Wenn Sie diese Fragen nicht mit etwas Spezifischerem als „Wir finden schon einen Weg“ beantworten können, adoptieren Sie keine Technologie. Sie übernehmen eine neue betriebliche Domäne.
Wo der Tradeoff sich lohnt
Ich will fair sein. Es gibt Situationen, in denen offene Tabellenformate die eindeutig richtige Wahl sind:
Sie entkommen aktiv einem Vendor Lock-in.
Wenn Ihr Warehouse-Anbieter die Preise erhöht, Features abschafft oder den Egress einschränkt, ist die Portabilität eines offenen Formats den betrieblichen Overhead wert. Die Alternative ist, gefangen zu bleiben.
Sie brauchen Time Travel und Rollback wirklich.
Einige Workloads – besonders in regulierten Branchen oder im Finanzdienstleistungssektor – erfordern die Fähigkeit, den historischen Zustand exakt zu rekonstruieren. Das Snapshot-Modell ist hier kein Nice-to-have. Es ist eine Compliance-Anforderung.
Sie betreiben mehrere Compute-Engines auf denselben Daten.
Wenn Ihr Analytics-Team Spark nutzt, Ihr BI-Team Trino und Ihre ML-Pipeline DuckDB, eliminiert ein gemeinsames offenes Tabellenformat den Extract-Transform-Load-Tanz zwischen Systemen. Die Koordinationskosten sind real, aber sie sind niedriger als die Pflege dreier separater Kopien desselben Datensatzes.
Sie haben das Team dafür.
Wenn Sie Engineers haben, die Metadatenformate, Compaction-Strategien und Katalog-Konsistenzmodelle verstehen, ist die betriebliche Last handhabbar. Wenn nicht, outsourcen Sie die Expertise an Berater und hoffen, dass sie verfügbar bleiben.
Wo layline.io passt
Bei layline.io verkaufen wir kein Tabellenformat. Wir verkaufen eine Processing-Runtime, die sowohl Batch- als auch Streaming-Workloads auf der Infrastruktur betreibt, die Sie bereits haben. Das schließt offene Tabellenformate ein, wenn sie Sinn ergeben, und traditionellen Speicher, wenn sie keinen Sinn ergeben.
Warum das wichtig ist: Viele Teams adoptieren Iceberg, weil sie Batch und Streaming koexistieren lassen müssen, und man hat ihnen gesagt, dass offene Tabellenformate der einzige Weg sind, sie zu vereinheitlichen. Das stimmt nicht. Die Vereinheitlichung geschieht auf der Processing-Ebene, nicht auf der Speicherebene. Wenn Ihre Runtime gut strukturierte Dateien im Batch-Modus schreiben und Micro-Batches im Streaming-Modus verarbeiten kann – während sie Compaction, Backfills und verspätete Daten im selben Workflow verwaltet – wird das Speicherformat zu einer Konfigurationsentscheidung, nicht zu einem architektonischen Commitment.
Wir sehen Teams, die Iceberg aus den richtigen Gründen adoptiert haben und dann festgestellt haben, dass der schwierige Teil nie das Format war. Es war die betriebliche Koordination darum: Batch- und Streaming-Pfade konsistent zu halten, Schema-Änderungen ohne Unterbrechung der Downstream-Consumer zu handhaben und sicherzustellen, dass dieselbe Geschäftslogik unabhängig davon dieselben Ergebnisse liefert, wann die Daten ankommen.
Darauf konzentrieren wir uns. Das Tabellenformat ist ein Detail. Das Betriebsmodell ist das, das bestimmt, ob das System um 2 Uhr nachts an einem Dienstag funktioniert.
Die Frage, die man vor der Demo stellen sollte
Wenn Ihnen ein Anbieter das nächste Mal eine glatte Iceberg-Demo zeigt – Time Travel, Partition-Evolution, Engine-Wechsel, der mühelos aussieht – fragen Sie ihn:
„Zeigen Sie mir den Compaction-Schedule. Zeigen Sie mir das Katalog-Failover. Zeigen Sie mir, was passiert, wenn ein Streaming-Job und ein Batch-Backfill auf dieselbe Partition treffen. Zeigen Sie mir die Speicherrechnung nach sechs Monaten Metadatenwachstum. Und zeigen Sie mir, wer gepaged wird, wenn eine Query-Engine einen teilweise geschriebenen Snapshot liest.“
Wenn die Antwort ein Verweis auf die Dokumentation ist, sehen Sie sich den einfachen Teil an. Der schwierige Teil ist das, was Sie die nächsten drei Jahre besitzen werden.
Offene Tabellenformate sind kein Betrug. Sie sind eine echte, wertvolle Technologie mit echten betrieblichen Kosten, die das Marketing selten erwähnt. Die Teams, die erfolgreich sind, sind diejenigen, die diese Kosten im Vorfeld kalkulieren, Verantwortlichkeiten zuweisen, bevor die erste Tabelle erstellt wird, und das Format als einen Bestandteil eines größeren betrieblichen Systems behandeln – nicht als eine magische Schicht, die Infrastrukturprobleme verschwinden lässt.
Die Demo ist der Anfang. Die Wartungsrechnung ist da, wo die Geschichte wirklich beginnt.
Wenn Ihr Team offene Tabellenformate abwägt und die vollen Total-Cost-of-Ownership verstehen möchte, kontaktieren Sie uns. Wir arbeiten mit Teams an genau diesem Problem – und die betriebliche Realität ist meist handhabbarer als die Angst, sobald man weiß, worauf man planen muss.
Andrew Tan ist Serial Entrepreneur und Gründer von layline.io und baut Unternehmensinfrastruktur für Datenverarbeitung, die Batch- und Echtzeit-Workloads im großen Maßstab bewältigt.