Orchestrieren Sie Real-time Datenströme in großem Maßstab
Ersetzen Sie fragile ETL-Batch-Jobs und fest verdrahtete iPaaS-Lösungen. Die Reactive Engine von layline.io macht aus chaotischen Event-Streams zuverlässige, skalierbare Dataflows, damit Ihre Entwickler schnell liefern und Ihr Betrieb dauerhaft stabil läuft.
Plattform Funktionen
Gebaut für Real-time im großen Maßstab, konzipiert für Entwicklergeschwindigkeit
Nahezu endlose Skalierbarkeit.
Skalieren Sie ohne Codeänderungen von 1.000 auf über 10 Millionen Ereignisse/Sekunde. Fügen Sie Knoten zu Ihrem Cluster hinzu und beobachten Sie, wie der Throughput linear wächst. Das Cluster Mesh verteilt Arbeitslasten über Regionen, Zonen oder Edge-Standorte. Richtlinien zur automatischen Skalierung passen die Kapazität an.
Beispiel für ein Skalierungsmuster. Die tatsächliche Leistung hängt von der Komplexität der Arbeitslast, dem Datenvolumen und der Infrastruktur ab.

Ereignisverarbeitung mit geringer Latenz.
Eine Reactive Engine verarbeitet Ereignisse im einstelligen Millisekundenbereich mit vorhersehbarer Latenz. Backpressure verhindert kaskadierende Ausfälle bei Verkehrsspitzen – Ereignisse fließen reibungslos, anstatt Ihre Pipeline zum Absturz zu bringen. Konfigurationsänderungen im laufenden Betrieb neu laden, ohne Container neu zu starten.
Erstellen Sie Pipelines in Stunden, nicht in Wochen.
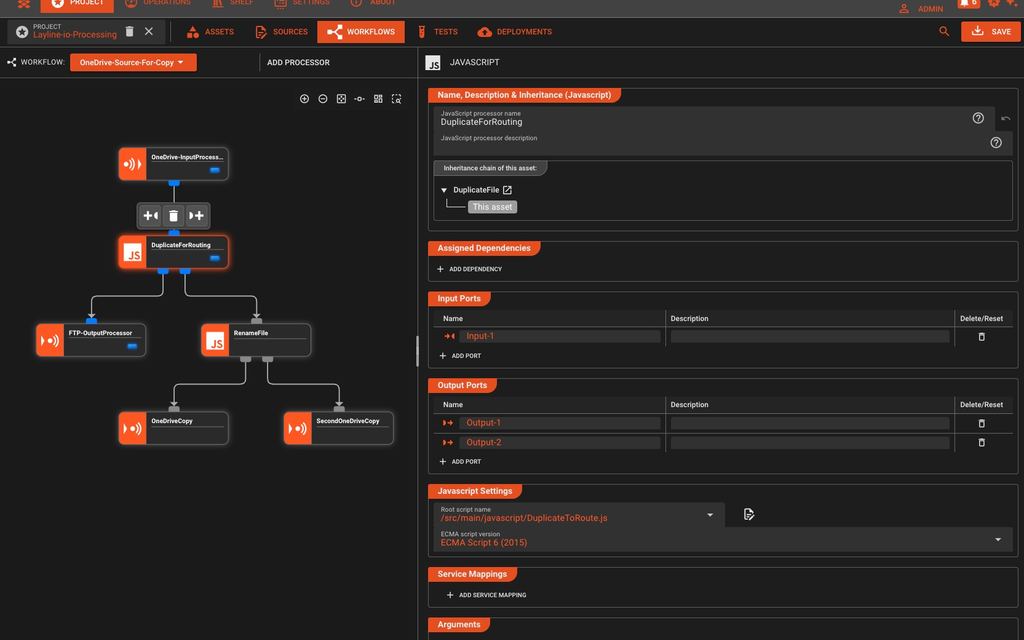
Der visuelle Workflow-Editor beschleunigt die Pipeline-Entwicklung – per Drag-and-Drop konfigurieren Sie Ihre Datenflüsse in wenigen Minuten. Wenn Sie benutzerdefinierte Logik benötigen, können Sie problemlos JavaScript- oder Python-Prozessoren einsetzen. Verwalten Sie mehrere Bereitstellungsziele mit umgebungsspezifischen Parametern – alles innerhalb eines einzigen Projekts. Verwalten Sie Konfigurationen mit Ihrem bevorzugten Versionskontrollsystem.


Integrierte Zuverlässigkeit auf Carrier-Niveau.
Upgrades ohne Ausfallzeiten, Garantien für eine exakte Zustellung und automatisches Failover. Integrierte Audit-Trails verfolgen jedes Ereignis von der Quelle bis zum Ziel. Real-time-Beobachtbarkeit mit Prometheus-Metrikunterstützung bedeutet, dass Sie Probleme erkennen, bevor Kunden es tun.
Developer Experience
Visuelle Workflows treffen auf Codeflexibilität – erstellen Sie Pipelines, die mit Ihrem Team skalieren
Visual Workflow Builder
Ziehen Sie Prozessoren per Drag-and-Drop, konfigurieren Sie Eigenschaften und verbinden Sie Flows – erstellen Sie komplexe Pipelines mit minimalem Code
- Visuelles Pipeline-Design per Drag-and-Drop
- Live-Validierung mit sofortiger Fehlerrückmeldung
- JSON-Konfigurationen und native Skriptdateien für die Versionskontrolle
- Alle Projektdateien in Standardformaten (JSON, JS, Python)
Geschäftslogik in JavaScript oder Python
Fügen Sie Skripte hinzu, wenn Sie benutzerdefinierte Transformationen, komplexe Validierungen oder externe API-Aufrufe benötigen
Message Anreicherung
Fügen Sie Geolokalisierungsdaten, Benutzerprofile oder Suchwerte aus externen Quellen hinzu
Betrugserkennung
Wenden Sie ML-Modelle oder regelbasierte Logik an, um verdächtige Transaktionen zu kennzeichnen
On-the-Fly-Assembly
Tracken und assembliereen Sie Nchrichten in Echtzeit mit dynamischen Zählern
Benutzerdefinierte Transformation
Gestalten Sie Datenstrukturen um, wenden Sie Geschäftsregeln an oder normalisieren Sie Formate
Arbeiten Sie mit jedem Datenformat
Analysieren Sie strukturierte Formate von einfachen CSV-Formaten bis hin zu komplexen Binärformaten durch Konfiguration. Parser für XML und ASN.1 verfügbar
- Flexible Definition von Datenformaten. Keine fest codierten Schemata.
- Schemavalidierung mit detaillierten Fehlermeldungen
- Konvertieren Sie direkt zwischen Formaten
- Formatierungs-Engines für XML, ASN.1, strukturierte ASCII, binär
Testen und debuggen Sie mit echten Daten
Message sniffing, Tests und umfassende Protokollierung machen das Debuggen von Produktionsproblemen unkompliziert
- Sniff Live-Nachrichten von jedem Workflow und Verarbeitungsschritt
- Schrittweise Skriptausführung mit Haltepunkten
- Untersuchen Sie Probleme mit detaillierten Protokollen und Fehlerberichten
- Geben Sie detaillierte Verarbeitungsinformationen zur Fehlerbehebung aus
Bereit für die Versionskontrolle
Alle Konfigurationen in JSON und nativen Skripten – vergleichen, zusammenführen und Änderungen mit jedem VCS verfolgen
- JSON-Konfigurationsdateien für alle Projekte
- Native Skriptdateien (JavaScript, Python)
- Verwenden Sie Git, SVN oder ein beliebiges Versionskontrollsystem
Nahezu sofortiges Hot-Reload
Konfiguration bereitstellen, aktivieren, Ergebnisse sehen – keine Container-Neustarts, keine Ausfallzeiten
- Sofortiges Feedback zu Konfigurationsänderungen
- Testen Sie in der Entwicklung und stufen Sie sie nahtlos in die Produktion um
- Wechseln Sie sofort zu vorherigen Konfigurationen zurück
Technische Architektur
Reaktive Streams, verteilte Verarbeitung und entwicklerorientiertes Design
Wie alles zusammenwirkt
layline.io orchestriert den Datenfluss von jeder Quelle zu jedem Ziel mithilfe einer reaktiven, ereignisgesteuerten Architektur. Ereignisse fließen durch Prozessoren, die Daten umwandeln, anreichern, aggregieren und weiterleiten – alles mit Backpressure-Behandlung und Garantien für die exakte einmalige Zustellung.
Kafka
REST APIs
Datenbanken
layline.io Reactive Engines
Data Lakes
Analytik
Webhooks
Reactive Streams
Pekko-Akteure verarbeiten Backpressure und asynchrone Verarbeitung
Prozessoren
Zuordnungs- und Filterprozessoren sowie benutzerdefinierte JavaScript/Python-Logik
Fehlerbehandlung
Transaktionskontrolle mit Commit-/Rollback-Unterstützung
Reactive Streams mit Apache Pekko
Basierend auf kampferprobten Pekko-Akteuren für nicht blockierende, asynchrone Ereignisverarbeitung
Umgang mit Backpressure
Stromabwärts langsam? Kein Problem. Reaktive Streams signalisieren dem Upstream automatisch, langsamer zu werden, und verhindern so einen Speicherüberlauf und kaskadierende Fehler.
Fehlerbehandlung und -wiederherstellung
Die Transaktionskontrolle mit Commit-/Rollback-Unterstützung gewährleistet die Datenintegrität. Definieren Sie benutzerdefinierte Fehlerbehandlungsrichtlinien und Wiederherstellungsstrategien pro Workflow-Schritt.
Bereitstellung in der Cloud, am Edge oder vor Ort
Visuelle Benutzeroberfläche, CLI-Befehle oder vollständige CI/CD-Automatisierung – Sie haben die Wahl
Kubernetes
Native Unterstützung
Cluster-Mesh
Multiregional
CLI Bereitstellen
Keine Ausfallzeiten
CI/CD Bereit
Vollständige Automatisierung
Bereitstellung über die Benutzeroberfläche
Visueller Bereitstellungsassistent

- Visueller Cluster-Selektor mit Gesundheitsstatus
- Workflow-Bereitstellung per Drag-and-Drop
- Live-Überwachung des Bereitstellungsfortschritts
Bereitstellung mittels CLI
Skriptfähige Automatisierung
- Ein-Befehl-Bereitstellungen mit Flags
- Shell-skriptfähig für die Automatisierung
- Exit-Codes für die Pipeline-Integration
CI/CD-Integration
GitHub-Aktionen, GitLab CI, Jenkins und mehr
- Automatisierte Rollbacks bei fehlgeschlagenen Health-Checks
- Blue-green-Bereitstellungen für null Ausfallzeiten
- Canary-Veröffentlichungen mit Verkehrsverlagerung
- Hooks vor/nach der Bereitstellung für benutzerdefinierte Logik
Full-Stack-Beobachtbarkeit
Real-time-Metriken, verteilte Ablaufverfolgung und Ereignisherkunftsverfolgung
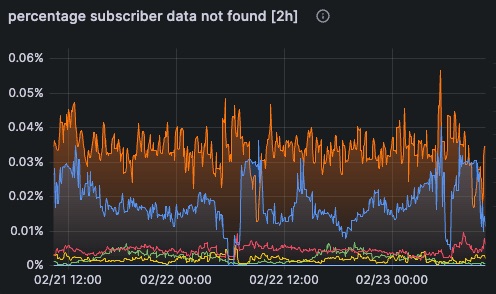
Prometheus-Metriken
Throughput, Latenzperzentile, Fehlerraten und benutzerdefinierte Geschäftsmetriken. Visualisieren Sie mit einem Dashboard Ihrer Wahl (z. B. Grafana).

Event Sniffing
Die verteilte Ablaufverfolgung zeigt den Ereignisfluss über Dienste hinweg. Verfolgen Sie ein einzelnes Ereignis von Kafka zur Datenbank usw.

Audit Trails
Jedes Ereignis wird mit detaillierten Informationen protokolliert. Produktionsprobleme beheben, Compliance nachweisen.
Open Source trifft Enterprise-ready
Kostenlos starten, unbegrenzt skalieren, nahtlos integrieren

Beginnen Sie frei und skalieren Sie, wenn Sie bereit sind.
Vollständig reaktive Engine mit unbegrenzten Knoten. Upgrade auf Enterprise für größere Volumina, Premium-Support und erweiterte Sicherheit – keine Migration erforderlich.
Kostenlos herunterladen
Integrieren Sie es in Ihren vorhandenen Stack.
Protokollbasierte Integration für Kafka, NATS, AWS Kinesis, Datenbanken (über JDBC), REST APIs und mehr. Transformieren Sie Daten im Handumdrehen mit JavaScript, Python oder SQL.
Entdecken Sie Integrationsoptionen
Entwickelt für die Zusammenarbeit im Team.
Benutzer- und rollenbasierte Zugriffskontrolle und kollaborative Workflow-Entwicklung. Vom Entwickler zum Produzenten mit Zuversicht.
Editionen vergleichenEntdecken Sie Mehr
Tauchen Sie tiefer in Anwendungsfälle, Vergleiche und detaillierte Funktionsaufschlüsselungen ein
Für wen ist eignet es sich?
Erfahren Sie, wie CTOs, Plattformingenieure, Dateningenieure und Analyseingenieure layline.io nutzen, um ihre einzigartigen Herausforderungen zu lösen.
Warum layline.io?
Verstehen Sie, was layline.io von herkömmlichen Integrationsplattformen und modernen Stream-Processing-Frameworks unterscheidet. Erfahren Sie mehr über unseren einzigartigen Ansatz zur Ereignisverarbeitung.
Vergleich anzeigenBranchenlösungen
Reale Implementierungen in den Bereichen Finanzen, Telekommunikation, E-Commerce, Gastgewerbe, Fertigung und IoT.
Detaillierte Funktionen
Entdecken Sie die Prozessoren, Operationen und erweiterten Funktionen wie Clustering und Bereitstellung.
Alle Funktionen ansehenPreise und Editionen
Vergleichen Sie die Editionen Community und Enterprise. Sehen Sie sich detaillierte Funktionsaufschlüsselungen, Preise und Supportoptionen an.
Editionen vergleichenBereit zum Start?
Laden Sie Community Edition herunter, vereinbaren Sie eine Demo oder sprechen Sie mit unserem Team über Ihren spezifischen Anwendungsfall.
Starten Sie kostenlos durchGeliebt von Branchenführern
Erfahren Sie, wie Unternehmen layline.io nutzen, um ihre Datenabläufe zu transformieren
„Die reaktive Engine von layline.io hat die Art und Weise, wie wir Hotelbuchungen und Gästedaten in über 60 Häusern verarbeiten, verändert. Real-time-Einblicke, die vorher unmöglich waren – jetzt rund um die Uhr ohne Ausfallzeiten.“
„Das Versprechen, völlig autark zu sein, wurde eingehalten zu 100%. Der ROI der Software zeigt sich bereits nach wenigen Wochen in Produktion.“


Erfahren Sie mehr über layline.io
Technische Artikel, Tutorials und Best Practices von unserem Engineering-Team
IBM besitzt Confluent. Kafka-Nutzer haben weiterhin ein Runtime-Problem.
Das Kafka-Protokoll ist weiterhin offen. Das kommerzielle Gravitationszentrum jedoch nicht. Sieben Monate nachdem IBM Confluent übernommen hat, drehen sich die wirklich wichtigen Fragen um Dual-Run, Replay und die Frage, wem Batch gehört, wenn die Streaming-Story watsonx heißt.
Streamhouse ist das neue Buzzword. Hier ist der Teil, der wirklich zählt.
Confluent, Aiven und Redpanda wollen Ihnen weismachen, dass Streamhouse alles verändert. Es verändert tatsächlich einiges. Aber es löst nicht das Problem, mit dem die meisten Teams tatsächlich zu kämpfen haben.
Data Products Fail When Nobody Owns the Runtime
Teams love calling their outputs 'data products.' But renaming a dashboard doesn't make it a product. The real test is who gets paged when it breaks at 2 AM — and whether they have the authority to fix it.