Par Andrew Tan
La démo qui ne vieillit jamais
Voici comment le pitch Iceberg se déroule habituellement :
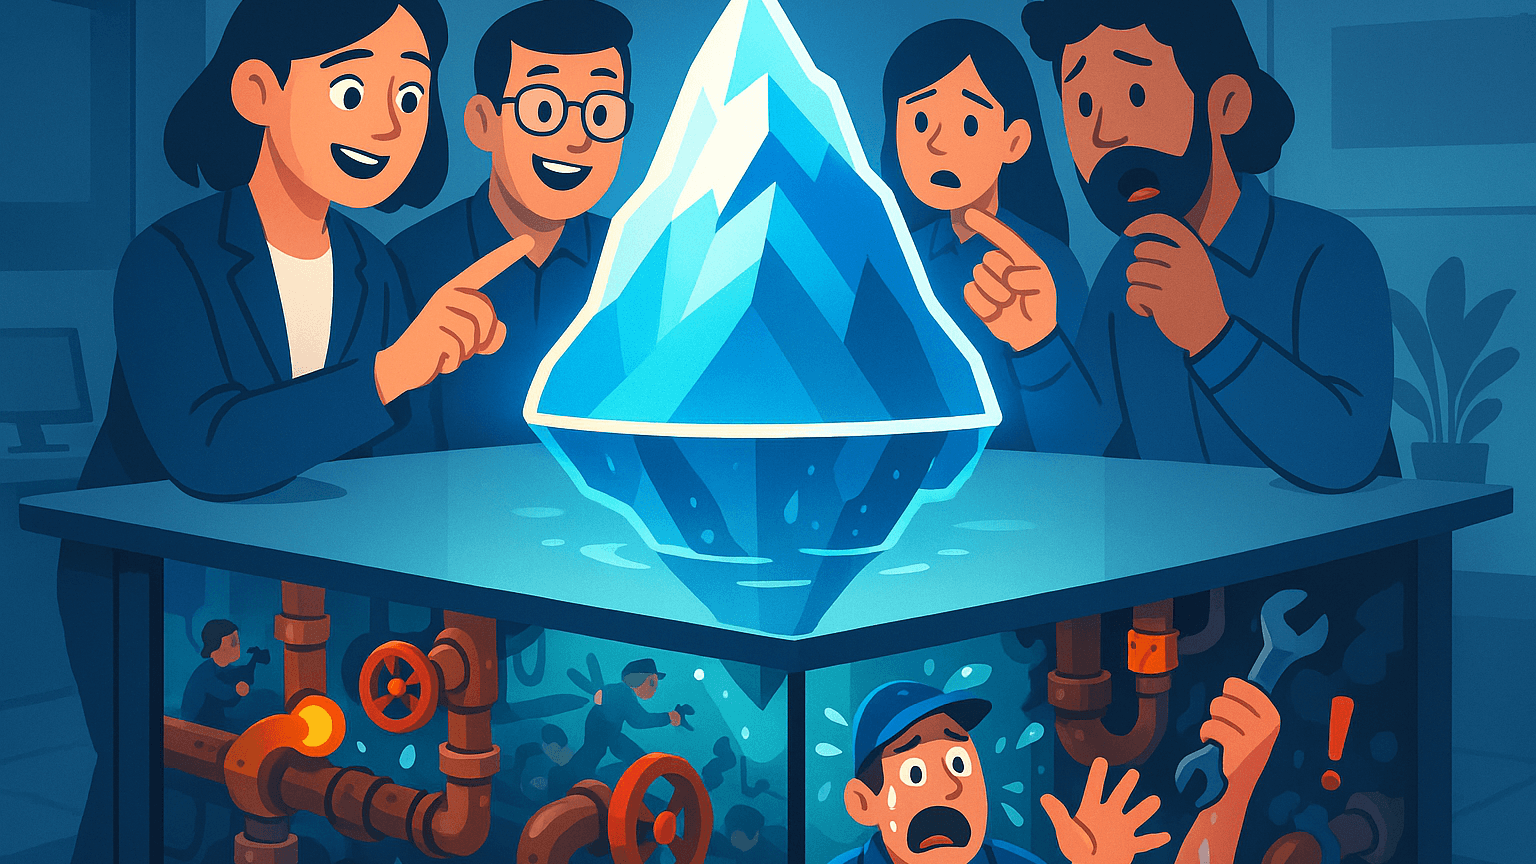
Un ingénieur se tient devant un écran et exécute une requête sur un jeu de données Parquet. Puis il exécute la même requête sur une table Iceberg. Les résultats sont identiques. L'audience hoche la tête. Puis l'ingénieur montre le retour à un instantané antérieur — la capacité de remonter dans le temps — et la salle s'anime vraiment. Quelqu'un pose une question sur l'évolution de schéma. L'ingénieur ajoute une colonne, ne réécrit rien, et les anciennes requêtes continuent de fonctionner. Le comité est convaincu.
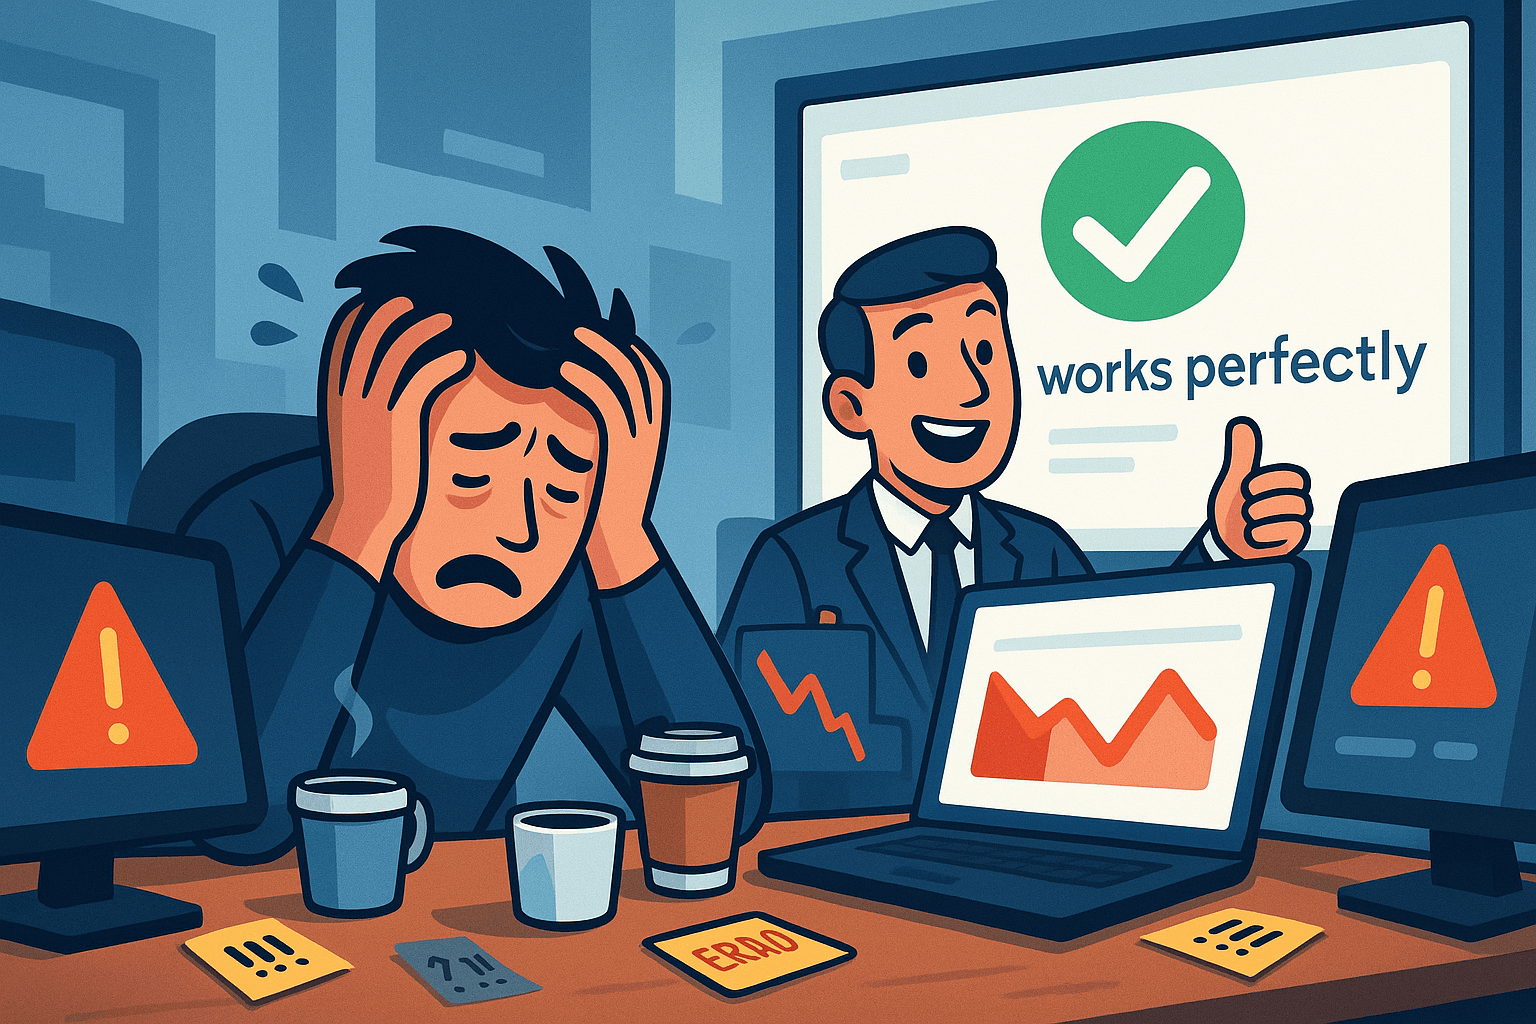
Six mois plus tard, la même équipe se trouve dans une autre salle. Celle-ci n'a pas d'écran. Juste un tableur, une liste d'alertes qui s'allonge, et une question que personne n'a posée pendant la démo :
Qui est responsable de la compaction ?
La démo montrait ce qu'Iceberg rend possible. Elle ne montrait pas ce qu'Iceberg fait devenir votre problème.
Ce que la spécification promet contre ce que l'équipe hérite
Les formats de table ouverts sont une avancée réelle. La portabilité entre moteurs, l'isolation par instantanés, l'évolution de partitionnement et le partitionnement masqué sont des capacités réelles qui résolvent de vraies douleurs. Si vous essayez d'échapper à un entrepôt verrouillé par un éditeur, Iceberg, Delta Lake et Hudi sont les meilleures issues.
Mais la spécification n'est pas le système. La spécification dit comment les métadonnées doivent être organisées. Elle ne dit pas comment votre équipe doit empêcher ces métadonnées de croître sans limite, comment coordonner la compaction entre plusieurs processus d'écriture, ou ce qui se passe quand deux moteurs de requête ne sont pas d'accord sur l'instantané à lire.
Voici ce que la démo passe sous silence :
La compaction n'est pas automatique
Chaque insertion, mise à jour et suppression crée de nouveaux fichiers et de nouvelles entrées de métadonnées. Laissés à eux-mêmes, les tables à forte vélocité accumulent des milliers de petits fichiers. Les performances des requêtes se dégradent. Les fichiers de métadonnées gonflent. La table qui semblait rapide lors de la démo commence à dépasser les délais en production. Quelqu'un doit planifier la compaction, la surveiller, l'optimiser et gérer les échecs quand deux jobs essaient de réécrire la même partition.
La prolifération des catalogues est réelle
Les tables Iceberg ont besoin d'un catalogue : Hive, Glue, Nessie, Polaris, un service REST personnalisé. Chaque catalogue a son propre modèle de cohérence, son propre mécanisme d'authentification, son propre cycle de montée de version. Une équipe qui adopte Iceberg pour éviter le verrouillage éditeur se retrouve souvent à gérer deux ou trois systèmes de catalogue au lieu d'un seul entrepôt. Le verrouillage se déplace du format de stockage vers la couche catalogue.
La politique de rétention est un problème distribué
Quand un instantané expire, Iceberg marque les données comme inaccessibles. Mais les fichiers sous-jacents existent toujours dans le stockage objet jusqu'à ce que quelque chose les supprime. Ce « quelque chose » est votre problème. Si vous définissez une rétention agressive pour économiser sur le stockage, vous risquez de perdre la capacité à revenir en arrière quand un job en aval produit de mauvais résultats. Si vous conservez tout, votre facture de stockage s'accumule tandis que votre bucket S3 se transforme en fouille archéologique.
Batch et streaming voient des tables différentes
Un job batch écrivant dans Iceberg produit de gros fichiers bien structurés. Un job streaming produit de petits fichiers fréquents. Si les deux chemins écrivent dans la même table, le planificateur de requêtes doit gérer deux agencements de fichiers radicalement différents. Le chemin streaming a besoin d'une compaction fréquente pour rester lisible. Le chemin batch a besoin de fichiers stables pour éviter les recalculs. Coordonner ces deux rythmes au sein d'une même table est plus difficile que les schémas d'architecture ne le suggèrent.
La démo montrait un seul processus d'écriture et un seul lecteur. La production fonctionne rarement comme ça.
Pourquoi l'« ouvert » crée une nouvelle fragmentation
La promesse des formats de table ouverts, c'est l'interopérabilité. Interroger les mêmes données depuis Spark, Trino, Flink, DuckDB, Snowflake, BigQuery. En pratique, chaque moteur prend en charge un sous-ensemble différent de la spécification, à un niveau de maturité différent.
Un moteur prend en charge les suppressions par position mais pas les suppressions par égalité. Un autre prend en charge la remontée dans le temps mais uniquement pour les tables écrites par son propre catalogue. Un troisième prend en charge l'évolution de partitionnement mais exige une version de métadonnées spécifique qui casse les anciens lecteurs. La table est « ouverte » en théorie. En pratique, elle est couplée à la combinaison spécifique de moteurs et de versions de catalogue que votre équipe utilise.
Ce n'est pas une critique des projets eux-mêmes. Iceberg, Delta et Hudi évoluent vite et s'améliorent rapidement. Le problème, c'est que les équipes les adoptent en espérant une libération et découvrent une nouvelle forme de surface opérationnelle. Au lieu d'un seul éditeur à blâmer, elles ont une matrice de compatibilités de versions à gérer.
Le coût caché, c'est la charge cognitive. Vos ingénieurs de données doivent désormais comprendre non seulement leurs pipelines, mais aussi la planification de la compaction, le modèle de cohérence du catalogue, la version du format de métadonnées et les comportements spécifiques à chaque moteur de chaque outil qui touche la table. Cette expertise ne vient pas d'une démo.
La checklist que personne ne remplit avant d'adopter
Si votre équipe évalue un format de table ouvert, voici les questions qui comptent plus que les performances d'une requête dans un benchmark :
Qui est responsable de la compaction, et que se passe-t-il en cas d'échec ?
La compaction n'est pas une configuration unique. C'est un processus d'arrière-plan continu qui rivalise pour les mêmes ressources de calcul que vos requêtes de production. Si la compaction prend du retard, les requêtes ralentissent. Si la compaction corrompt une partition, la récupération est manuelle et stressante. Vous avez besoin d'un propriétaire, d'un runbook et d'un moyen de détecter quand la compaction ne suit plus.
Quelle est votre stratégie de sortie du catalogue ?
Les catalogues sont le véritable point de verrouillage. Si vous vous engagez avec Glue aujourd'hui, pourrez-vous migrer vers Nessie ou Polaris plus tard sans réécrire les chemins des tables et reconfigurer chaque job en aval ? La plupart des équipes ne testent cela qu'au moment où elles y sont contraintes.
Comment gérez-vous les données tardives et les rattrapages ?
Les rattrapages batch et les arrivées tardives en streaming réécrivent tous deux des partitions historiques. Les formats de table ouverts gèrent cela mieux que du Parquet brut, mais ils n'éliminent pas le problème de coordination. Si un rattrapage s'exécute pendant qu'un job streaming ajoute des données à la même partition, vous devez comprendre la sémantique d'isolation, le comportement de retry et exactement ce que chaque moteur fait quand il voit un conflit.
Quel est votre plan de croissance des métadonnées ?
Les fichiers de métadonnées sont petits mais ils se multiplient. Une table avec des instantanés quotidiens et une compaction horaire peut générer des milliers de fichiers de métadonnées par mois. Le stockage objet est bon marché, mais les opérations LIST ne sont pas gratuites. Certains moteurs de requête chargent l'arbre de métadonnées complet en mémoire. À une certaine échelle, les métadonnées elles-mêmes deviennent un goulot d'étranglement de performance.
Qui est appelé en astreinte quand une requête renvoie de mauvais résultats ?
L'isolation par instantanés est excellente jusqu'à ce que quelqu'un lise le mauvais instantané parce que le catalogue a été brièvement incohérent. Ou parce qu'un job streaming a commité un batch incomplet. Ou parce que deux moteurs ont interprété le même fichier de métadonnées différemment. Déboguer ces problèmes nécessite une expertise du format, du catalogue et du moteur spécifique. La rotation d'astreinte vient de s'allonger.
Si vous ne pouvez pas répondre à ces questions avec quelque chose de plus précis que « on verra », vous n'adoptez pas une technologie. Vous prenez en charge un nouveau domaine opérationnel.
Quand le compromis en vaut la peine
Je veux être juste. Il y a des situations où les formats de table ouverts sont le bon choix évident :
Vous échappez activement au verrouillage éditeur.
Si votre fournisseur d'entrepôt augmente ses prix, déprécie des fonctionnalités ou limite les sorties de données, la portabilité d'un format ouvert vaut le surcoût opérationnel. L'alternative reste d'être piégé.
Vous avez réellement besoin de remonter dans le temps et de revenir en arrière.
Certaines charges de travail — surtout dans les secteurs réglementés ou les services financiers — exigent la capacité de reconstruire exactement un état historique. Le modèle d'instantanés n'est pas un plus ici. C'est une exigence de conformité.
Vous faites tourner plusieurs moteurs de calcul sur les mêmes données.
Si votre équipe d'analytique utilise Spark, votre équipe BI utilise Trino et votre pipeline de ML utilise DuckDB, un format de table ouvert partagé élimine la danse ETL entre les systèmes. Le coût de coordination est réel, mais il est inférieur à celui de maintenir trois copies distinctes du même jeu de données.
Vous avez l'équipe pour ça.
Si vous disposez d'ingénieurs qui comprennent les formats de métadonnées, les stratégies de compaction et les modèles de cohérence des catalogues, la charge opérationnelle est gérable. Sinon, vous externalisez l'expertise auprès de consultants et espérez qu'ils restent disponibles.
Où s'inscrit layline.io
Chez layline.io, nous ne vendons pas de format de table. Nous vendons un runtime de traitement qui gère à la fois les charges de travail batch et streaming sur l'infrastructure que vous avez déjà. Cela inclut les formats de table ouverts quand ils ont du sens, et le stockage traditionnel quand ce n'est pas le cas.
La raison pour laquelle cela compte : beaucoup d'équipes adoptent Iceberg parce qu'elles ont besoin que le batch et le streaming coexistent, et on leur a dit que les formats de table ouverts étaient le seul moyen de les unifier. Ce n'est pas vrai. L'unification se fait au niveau du runtime de traitement, pas au niveau du stockage. Si votre runtime peut écrire des fichiers bien structurés en mode batch et gérer des micro-batches en mode streaming — tout en gérant la compaction, les rattrapages et les données tardives dans le même workflow — le format de stockage devient un choix de configuration, pas un engagement architectural.
Nous voyons des équipes qui ont adopté Iceberg pour de bonnes raisons et ont ensuite découvert que la partie difficile n'était jamais le format. C'était la coordination opérationnelle autour : maintenir les chemins batch et streaming cohérents, gérer les changements de schéma sans casser les consommateurs en aval, et s'assurer que la même logique métier produit les mêmes résultats quelles que soient les heures d'arrivée des données.
C'est sur ce problème que nous nous concentrons. Le format de table est un détail. Le modèle opérationnel est ce qui détermine si le système fonctionne à 2 h du matin un mardi.
La question à poser avant la démo
La prochaine fois qu'un vendeur vous montre une démo brillante d'Iceberg — remontée dans le temps, évolution de partitionnement, changement de moteur qui semble sans effort — posez-lui ceci :
"Montrez-moi le planning de compaction. Montrez-moi le basculement de catalogue. Montrez-moi ce qui se passe quand un job streaming et un rattrapage batch touchent la même partition. Montrez-moi la facture de stockage après six mois de croissance des métadonnées. Et montrez-moi qui est appelé en astreinte quand un moteur de requête lit un instantané qui a été partiellement écrit."
Si la réponse est une référence à la documentation, vous regardez la partie facile. La partie difficile est ce que vous allez posséder pendant les trois prochaines années.
Les formats de table ouverts ne sont pas une arnaque. Ce sont une technologie réelle et précieuse, avec un coût opérationnel réel que le marketing mentionne rarement. Les équipes qui réussissent sont celles qui évaluent ce coût à l'avance, désignent un propriétaire avant que la première table ne soit créée, et considèrent le format comme un composant d'un système opérationnel plus large — pas comme une couche magique qui fait disparaître les problèmes d'infrastructure.
La démo est le commencement. La facture de maintenance est là où l'histoire commence vraiment.
Si votre équipe pèse le pour et le contre des formats de table ouverts et essaie d'en comprendre le coût total de possession, contactez-nous. Nous travaillons avec des équipes sur ce problème précis — et la réalité opérationnelle est généralement plus gérable que la crainte, une fois que l'on sait ce qu'il faut prévoir.
Andrew Tan est un entrepreneur en série et fondateur de layline.io, construisant une infrastructure de traitement de données d'entreprise qui gère à la fois les charges de travail batch et en temps réel à grande échelle.