Idées & Actualités
Articles, tutoriels et idées sur l'intégration de données, le traitement d'événements et la création de Workflows évolutifs.
Streamhouse est le nouveau mot à la mode. Voici la partie qui compte vraiment.
Confluent, Aiven et Redpanda veulent vous faire croire que le streamhouse change tout. Il change certaines choses. Mais il ne résout pas le problème auquel la plupart des équipes sont réellement confrontées.
Data Products Fail When Nobody Owns the Runtime
Teams love calling their outputs 'data products.' But renaming a dashboard doesn't make it a product. The real test is who gets paged when it breaks at 2 AM — and whether they have the authority to fix it.
dbt quitte l'entrepôt. Vos pipelines sont-ils prêts ?
dbt a construit le workflow d'analytique moderne. Maintenant, la couche de transformation se déplace en amont — et l'écart entre les modèles SQL et l'exécution en temps réel devient le goulot d'étranglement que personne n'avait prévu.
Iceberg est facile à démontrer. La facture de maintenance arrive plus tard.
Les formats de table ouverts résolvent la portabilité. Ils ne résolvent pas l'exploitation. Le vrai travail commence après le post de lancement : compaction, rétention, prolifération multi-catalogues et maintien de la cohérence entre les chemins batch et streaming.
La conformité échoue en transit : pourquoi la gouvernance des données doit s'étendre au pipeline
La plupart des programmes de gouvernance se concentrent sur les données au repos. Le véritable point de défaillance se situe dans les données en mouvement — flux CDC, jobs d'enrichissement, jointures en streaming et Workflows déclenchés par l'IA. Voici à quoi ressemble la gouvernance lorsqu'on l'applique pendant que les données sont encore en transit.
Assez frais pour un agent IA ? Le budget de fraîcheur des données que personne ne définit
La plupart des équipes considèrent le contexte de l'IA comme un problème de stockage. La question la plus difficile est de savoir si les données sont suffisamment fraîches pour l'action que l'agent est sur le point de prendre.
Pourquoi 85 % des entreprises ne sont pas prêtes pour l'IA
Le benchmark de Fivetran en 2026 a révélé que 85 % des entreprises utilisant l'IA agentique fonctionnent sur une infrastructure qui n'est pas prête. Le modèle n'est pas le problème. Les data pipelines qui l'alimentent le sont.
Les coûts cachés de la construction de votre propre couche d'intégration Batch-Streaming
Avec le codage assisté par l'IA, construire vos propres Data Pipelines semble moins cher que jamais. Mais les vrais coûts ne sont pas dans la construction initiale—ils sont dans la maintenance, les rotations d'astreinte, et la complexité accumulée qui s'accumule au fil du temps.
Le marché de l'orchestration se consolide. Voici pourquoi c'est une bonne nouvelle pour les équipes data.
Dagster rejoint Prefect, ce qui signale la fin des orchestrateurs autonomes. Les gagnants seront les plateformes unifiées qui combinent orchestration et traitement — et c'est exactement la direction que prend le marché.
Le CDC, la tuyauterie que tout le monde oublie jusqu'à ce qu'elle tombe en panne
Le Change Data Capture est la couche invisible qui rend possible l'analytique en temps réel et les systèmes orientés événements — mais la plupart des équipes ne s'y intéressent qu'après leur premier incident en production
Votre Data Warehouse n'est pas votre Data Pipeline
Les équipes forcent sans cesse leur Data Warehouse à assumer une intégration pour laquelle il n'a jamais été conçu. Résultat : des coûts qui explosent, des pannes opaques et des architectures de plus en plus difficiles à maintenir au fur et à mesure qu'elles « réussissent ». Voici pourquoi il faut séparer le mouvement des données du stockage analytique.
L'écart de productivité de l'IA : Pourquoi les chiffres ne correspondent pas
Chaque tableau de bord d'entreprise affirme que l'IA transforme l'entreprise. Les chiffres réels de productivité racontent une histoire très différente — et comprendre pourquoi est important pour chaque équipe prenant des décisions d'investissement dans l'IA.
L'Ingénieur de Données IA : Ce qui a Vraiment Changé (Et Ce qui n'a Pas Changé)
Chaque blog concurrent publie 'L'IA change l'ingénierie des données.' Tout est exalté et vague. Voici l'inventaire honnête — ce que les outils LLM aident réellement, ce qu'ils ne peuvent toujours pas toucher, et pourquoi les affirmations de '80% d'automatisation' ne survivent pas au contact avec la production.
Les contrats de données sont la versionnage d'API dont votre Data Pipeline a besoin
La dérive de schéma continue de casser les pipelines parce que nous surveillons les changements au lieu d'appliquer des contrats. Voici pourquoi les contrats de données sont la couche manquante entre vos producteurs et consommateurs.
La Traçabilité des Données Est une Mesure de Vanité Sans Contexte Commercial
La plupart des outils de traçabilité produisent de beaux diagrammes qui ne répondent pas à la seule question qui compte : 'Qu'est-ce qui se casse si ces données sont incorrectes ?' Voici comment passer du théâtre de l'observabilité à une traçabilité essentielle pour l'entreprise.
Pourquoi j'ai cessé de croire aux 'meilleures pratiques' et commencé à faire confiance à 'ce qui fonctionne pour nous'
J'ai passé 18 mois à construire l'architecture 'parfaite'. Puis j'ai vu un client la supprimer en 20 minutes et la remplacer par une tâche cron. Voici ce que j'ai appris sur le piège des 'meilleures pratiques' — et pourquoi la technologie ennuyeuse gagne souvent.
Ce que j'ai appris en lisant 50 postmortems de Data Pipeline
Après avoir analysé 50 postmortems publics d'Uber, Netflix, Stripe, et d'autres, quatre schémas d'échec émergent encore et encore. La plupart d'entre eux sont évitables à l'étape de conception.
Vous n'avez pas échappé à la complexité d'Airflow — Vous l'avez juste distribuée
Ajouter Kestra, Dagster ou Prefect à côté d'Airflow ne réduit pas la complexité de l'orchestration. Cela la multiplie. Voici à quoi ressemble réellement la dette de coordination cachée — et que faire à ce sujet.
Pourquoi votre équipe de données ne peut pas livrer : le goulot d'étranglement organisationnel dont personne ne parle
Le plus grand obstacle à la productivité des équipes de données n'est pas la technologie—c'est la friction organisationnelle. Voici comment les chaînes d'approbation, la fragmentation des outils, et la propriété peu claire créent des goulots d'étranglement qu'aucun talent en ingénierie ne peut surmonter.
Qlik Acquiert Talend – Observations sur les Renouvellements Post-Acquisition et Alternatives.
Certains clients de Talend ont signalé des augmentations significatives des prix de renouvellement suite à l'acquisition de Talend par Qlik. Cet article partage des informations disponibles publiquement et des expériences individuelles de clients, et décrit ce que les entreprises évaluant leurs options devraient considérer.
Que se passe-t-il avec votre Pipeline lorsque le système source change sans avertissement
La dérive de schéma et les changements en amont qui cassent sont la première cause des échecs de données silencieux. Voici comment éviter d'être pris au dépourvu.
Que se passe-t-il pour votre Pipeline lorsque le système source change sans avertissement
La dérive de schéma et les changements en amont qui cassent sont la première cause des échecs de données silencieux — mais la plupart du contenu sur les pipelines se concentre sur l'infrastructure, pas sur le comportement du système source
Intégration des Données Financières : Un Guide Pratique
Qu'est-ce que l'intégration des données financières ? Découvrez pourquoi l'intégration des données financières est particulièrement difficile, comment elle diffère de l'ETL classique, et les modèles éprouvés que les équipes utilisent pour la résoudre.
layline.io vs. Apache Kafka : Quand choisir quoi
Une comparaison pratique des approches de traitement de flux — couvrant la latence, la complexité opérationnelle, et l'adéquation de l'équipe qui détermine réellement le bon choix
Pourquoi l'Intégration de Données en Temps Réel est Importante pour les Applications Modernes
La différence entre le quasi-temps-réel et le véritable temps-réel, et pourquoi cet écart coûte plus cher que vous ne le pensez
Pourquoi la plupart des Data Pipelines échouent à 3h du matin (et comment en construire qui ne le font pas)
Les vraies raisons pour lesquelles les Data Pipelines de production se cassent au milieu de la nuit — et les pratiques d'ingénierie qui les empêchent
La Migration Streaming Que Personne N'a Demandée
Un architecte de données d'une entreprise du Fortune 500 m'a dit un jour qu'ils avaient passé 14 mois à migrer vers Kafka — puis ont discrètement rétabli la moitié des pipelines en mode batch. Voici pourquoi cela continue de se produire, et ce que je ferais à la place.
Quand vos pipelines Airflow doivent passer au temps réel
Vous avez Airflow en fonctionnement. Votre équipe le connaît. Les DAGs fonctionnent. Alors pourquoi entendez-vous soudainement 'nous avons besoin de temps réel' — et que pouvez-vous réellement faire à ce sujet ?
Traitement en périphérie qui permet réellement d'économiser de l'argent
Comment le filtrage local des données peut réduire votre facture Cloud de 90 % — Et à quoi pourrait ressembler le vôtre
De la Batch au Streaming : Un Guide Pratique des Pipelines de Données Modernes
Pourquoi les données en temps réel sont importantes, ce qui rend la migration difficile, et comment penser à la transition — que vous choisissiez layline.io ou une autre voie
Votre Facture Cloud a Appelé. Elle Veut Parler de Serverless.
De la scalabilité invisible aux factures invisibles—pourquoi les équipes d'ingénierie abandonnent FaaS pour des moteurs de données persistants et prévisibles.
Découvrez la puissance d'Apache Pekko avec layline.io
Chez layline.io, nous avons exploité les capacités robustes d'Apache Pekko pour vous offrir une plateforme complète de traitement d'événements à faible code. Avec notre solution, vous pouvez tirer parti du plein potentiel d'Apache Pekko sans écrire une seule ligne de code.
La puissance de la Data Orchestration avec layline.io : Un scénario de démonstration Ubiquity Unifi
À une époque où les données règnent en maître, gérer et orchestrer l'immense océan d'informations est devenu l'épine dorsale de nombreuses entreprises et industries.
layline.io : Révolutionner la scène des startups IT de Hambourg avec une expertise en traitement des données d'événements
layline.io sélectionné comme l'une des startups IT les plus influentes de Hambourg, Allemagne par EU Startup News.
H-Hotels.com - Transformation Numérique avec layline.io
L'industrie hôtelière a connu des avancées technologiques significatives ces dernières années. Cela inclut les logiciels de Data Integration étant l'un des outils les plus critiques que l'industrie peut exploiter pour optimiser leurs opérations.
L'avantage du traitement de données asynchrone basé sur les événements
Dans le monde rapide d'aujourd'hui, chaque entreprise cherche de meilleures façons de traiter de grands volumes de données. Les méthodes traditionnelles de traitement des données ont leurs limites, c'est pourquoi les entreprises explorent de plus en plus le traitement de données asynchrone basé sur les événements.
layline.io - Une comparaison avec Kafka
Comment layline.io se compare-t-il à Kafka ? C'est une question que nous entendons de temps en temps. Nous nous demandons pourquoi.

Série d'exemples : Requêtes Http-Client
Les interfaces ReST sont populaires et abondantes. Nous vous montrons comment configurer des requêtes Http-Client dans layline.io en utilisant Yahoo Finance comme exemple.
Sniffing Real-Time Data
Il est difficile de comprendre ce qui se passe réellement dans des scénarios de traitement complexes. layline.io aide en fournissant des outils de sondage pour obtenir des informations sur le fonctionnement interne des Workflows complexes en temps réel.
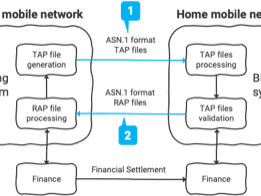
Configuration du format ASN.1
ASN.1 est encore un format de données populaire. Découvrez à quel point il est facile de configurer n'importe quel format ASN.1 dans layline.io.
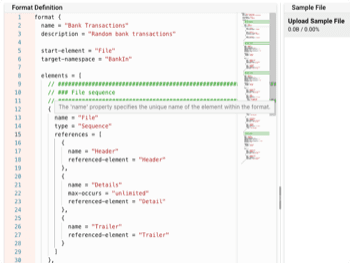
Maudit enfer des formats de données
Gérer des formats de données complexes et des changements peut être intimidant. Découvrez comment layline.io relève ce défi en utilisant un langage de grammaire configurable.

Sortie vers Kafka
Démonstration sur la façon de lire des données à partir d'un fichier structuré, de mapper les données des enregistrements et de sortir les données vers le cloud Kafka.
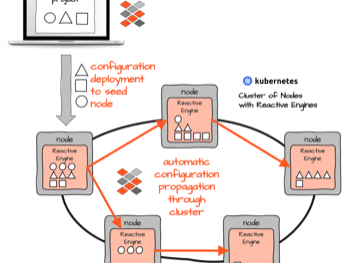
Avantage des Workflows layline.io par rapport aux Microservices traditionnels utilisant le modèle K8S/Docker
Le modèle traditionnel de Microservices sur Kubernetes/Docker présente certains inconvénients qui entraînent une gestion excessivement complexe et une consommation de ressources élevée. Nous expliquons le contexte et comment layline.io peut aider.
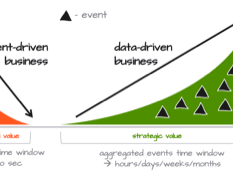
Basé sur les événements ou rien !? Passez-vous à côté si votre entreprise n'est pas basée sur les événements ?
Vous pourriez passer à côté si vous êtes uniquement axé sur les données. En fait, chaque entreprise est axée sur les données. Mais vous devriez vous demander ce que cela signifie vraiment et si cela sera suffisant pour vous demain.
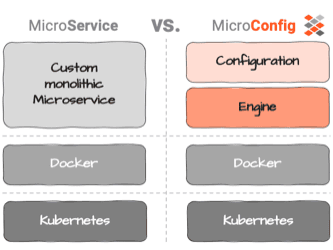
Réparer ce qui ne va pas avec les Microservices
Depuis quelques années, les Microservices et les architectures orientées services sont très en vogue. Mais il y a des inconvénients. Peuvent-ils être surmontés ?
Gérer la pression des données dans les systèmes basés sur les messages
Comment gérer la pression des données dans des solutions non-stop basées sur les messages et garantir une disponibilité continue sous charge.
Restez informé
Recevez les derniers articles, tutoriels et mises à jour directement dans votre boîte de réception.
Pas de spam. Désabonnement à tout moment.