アンドリュー・タンによる
いつまでも新しいデモ
Icebergの営業トークは通常、次のように進む。
エンジニアが画面の前に立ち、Parquetデータセットに対してクエリを実行する。次に同じクエリをIcebergテーブルに対して実行する。結果は同じだ。聴衆はうなずく。そしてエンジニアがタイムトラベルを見せる—以前のスナップショットにロールバックすると、部屋がざわめく。誰かがスキーマ進化について尋ねる。エンジニアは列を追加し、何も書き換えず、古いクエリはそのまま動く。承認委員会は決心する。
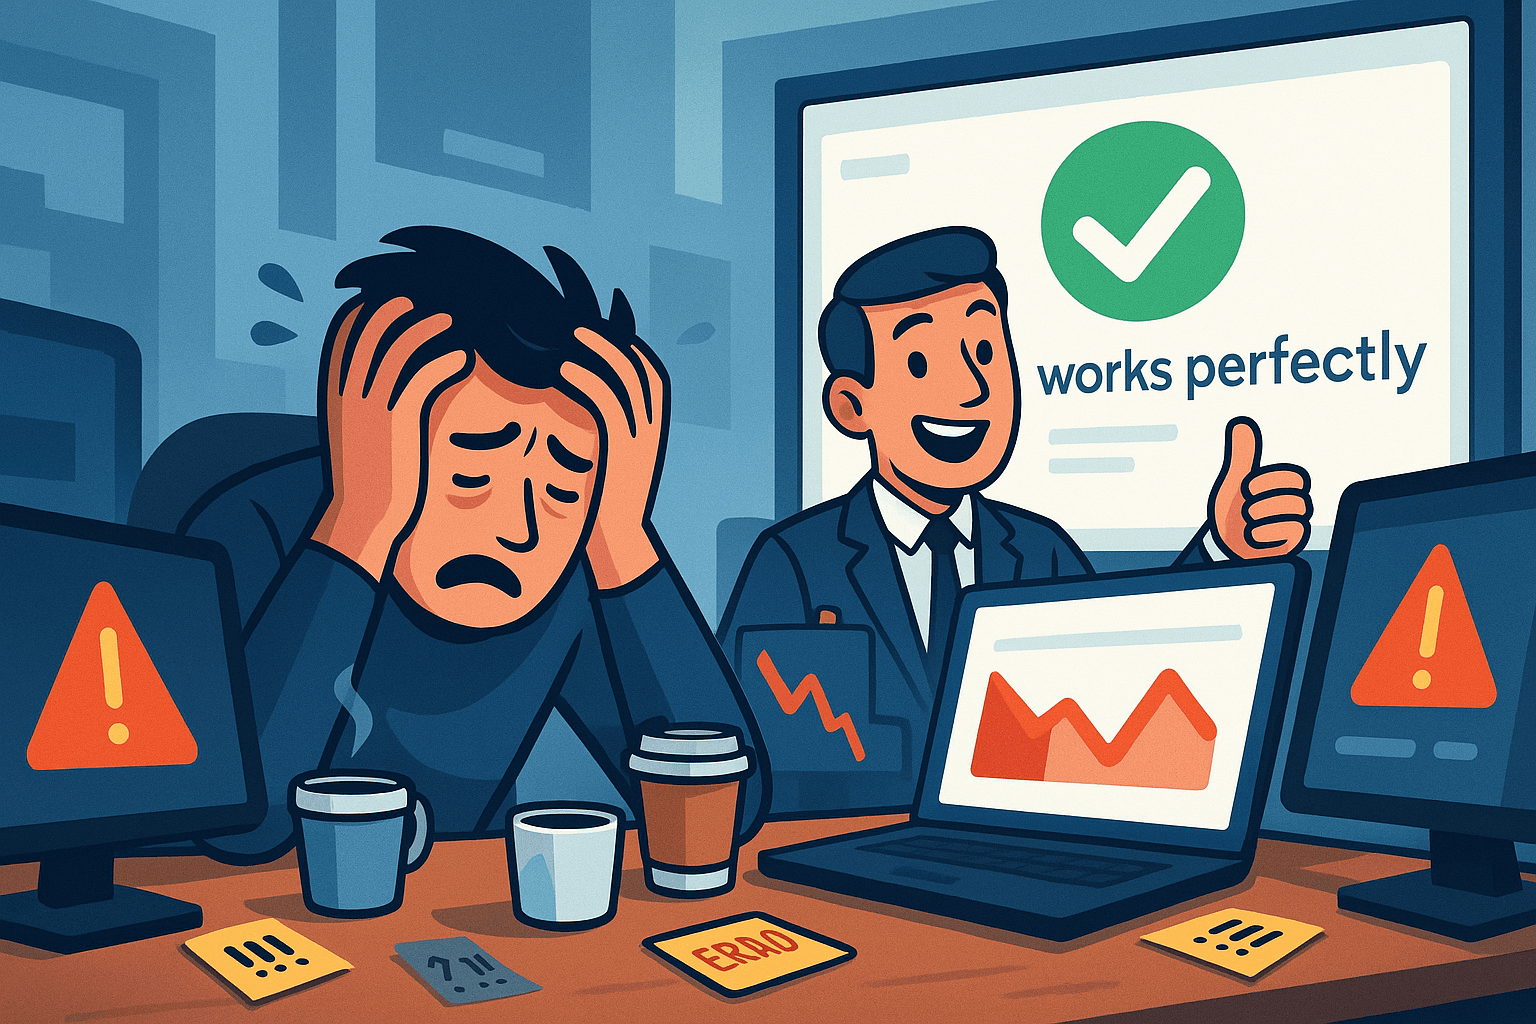
6か月後、同じチームは別の部屋にいる。そこには画面がない。スプレッドシートと増え続けるアラートのリスト、そしてデモ中に誰も尋ねなかった質問がある。
コンパクションの所有者は誰か?
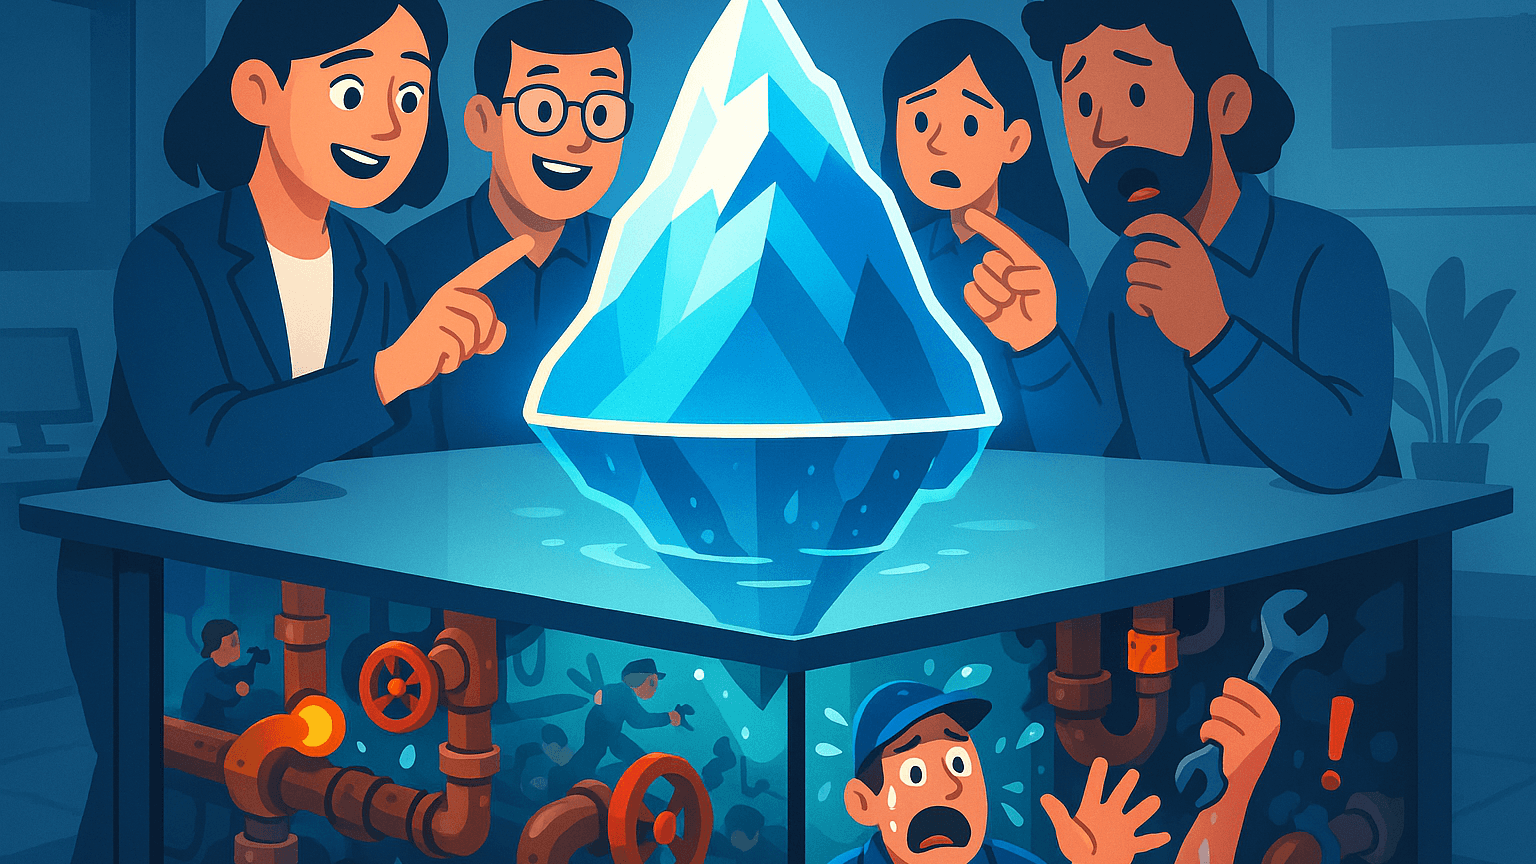
デモはIcebergが可能にすることを見せた。Icebergがあなたの問題にすることを見せたわけではない。
スペックが約束すること vs チームが引き継ぐこと
オープンテーブルフォーマットは本当の進歩だ。エンジン間の移植性、スナップショット分離、パーティション進化、隠しパーティショニングは、実際の痛みを解決する実際の機能だ。ベンダーロックインのデータウェアハウスから脱出しようとしているなら、Iceberg、Delta Lake、Hudiは最善の脱出経路だ。
しかし、スペックはシステムではない。スペックはメタデータをどう配置すべきかを示す。メタデータが無制限に増えないようチームがどう保つか、複数のライター間でコンパクションをどう調整するか、2つの異なるクエリエンジンがどのスナップショットを読むかで意見が食い違ったときに何が起こるかまでは示さない。
デモが飛ばしているのは以下だ。
コンパクションは自動ではない
すべてのinsert、update、deleteは新しいファイルと新しいメタデータエントリを生む。そのままにしておくと、高頻度のテーブルは数千の小さなファイルを蓄積する。クエリ性能が低下する。メタデータファイルが肥大化する。デモでは速く見えたテーブルが本番でタイムアウトし始める。誰かがコンパクションをスケジュールし、監視し、チューニングし、2つのジョブが同じパーティションを書き換えようとしたときの障害を処理しなければならない。
カタログの蔓延は現実だ
Icebergテーブルにはカタログが必要だ:Hive、Glue、Nessie、Polaris、カスタムRESTサービス。それぞれのカタログには独自の一貫性モデル、認証、アップグレードサイクルがある。ベンダーロックインを避けるためにIcebergを採用したチームが、しばしば1つのデータウェアハウスではなく2つか3つのカタログシステムを管理することになる。ロックインはストレージフォーマットからカタログ層に移る。
保持ポリシーは分散問題だ
スナップショットが期限切れになると、Icebergはそのデータを到達不能とマークする。しかし、基盤のファイルは何かが削除するまでオブジェクトストレージに残っている。その「何か」はあなたの問題だ。ストレージを節約するために攻撃的な保持期間を設定すると、下流のジョブが悪い結果を生み出したときにロールバックする能力を失うかもしれない。すべてを保持すれば、ストレージ料金が複利で増え、S3バケットが考古学的発掘現場になる。
バッチとストリーミングは異なるテーブルを見る
Icebergに書き込むバッチジョブは大きく構造化の整ったファイルを生む。ストリーミングジョブは小さく頻繁なファイルを生む。両方のパスが同じテーブルに書き込む場合、クエリプランナーは2つの全く異なるファイルレイアウトを扱わなければならない。ストリーミングパスは読みやすさを保つために頻繁なコンパクションを必要とする。バッチパスは再計算を避けるために安定したファイルを必要とする。1つのテーブルでこれら2つのリズムを調整することは、アーキテクチャ図が示すより難しい。
デモは単一のライターと単一のリーダーを見せた。本番がそのように動くことはめったにない。
なぜ「オープン」が新しい断片化を生むか
オープンテーブルフォーマットの約束は相互運用性だ。同じデータをSpark、Trino、Flink、DuckDB、Snowflake、BigQueryからクエリできる。実際には、各エンジンは異なる成熟度でスペックの異なるサブセットをサポートしている。
1つのエンジンは位置削除をサポートするが等値削除はサポートしない。もう1つはタイムトラベルをサポートするが、独自のカタログで書かれたテーブルに限る。3つ目はパーティション進化をサポートするが、古いリーダーを壊す特定のメタデータバージョンを必要とする。テーブルは理論上「オープン」だ。実際には、チームが実行している特定のエンジンとカタログバージョンの組み合わせに結合されている。
これはプロジェクト自体を批判しているわけではない。Iceberg、Delta、Hudiは急速に進化し改善している。問題は、チームがそれらを解放を期待して採用し、新しい種類の運用表面積を発見することだ。責任をなすりつけるべきベンダーが1社ではなく、管理しなければならないバージョン互換性のマトリックスができる。
隠れたコストは認知負荷だ。データエンジニアは自分たちのパイプラインだけでなく、コンパクションのスケジューリング、カタログの一貫性モデル、メタデータフォーマットバージョン、テーブルに触れるすべてのツールのエンジン固有の振る舞いを理解する必要がある。その専門知識はデモからは得られない。
採用前に誰も実行しないチェックリスト
チームがオープンテーブルフォーマットを評価しているなら、ベンチマークのクエリ性能より重要な質問がある。
コンパクションの所有者は誰か、失敗したときどうなるか?
コンパクションは一度きりのセットアップではない。本番クエリと同じコンピュートリソースを奪い合う継続的なバックグラウンドプロセスだ。コンパクションが遅れるとクエリが遅くなる。コンパクションがパーティションを破損させると、復旧は手作業でストレスフルになる。所有者、手順書、コンパクションが追いついていないことを検出する方法が必要だ。
カタログからの出口戦略は何か?
カタログが本当のロックインポイントだ。今日Glueにコミットした場合、後でNessieやPolarisに移行するにはテーブルパスを書き換え、下流のすべてのジョブを再設定しなければならない。ほとんどのチームは強制されるまでこれをテストしない。
遅延データやバックフィルはどう扱うか?
バッチバックフィルとストリーミングの遅延到着は、どちらも過去のパーティションを書き換える。オープンテーブルフォーマットは生のParquetよりもこれをうまく処理するが、調整問題を消すわけではない。バックフィルがストリーミングジョブと同じパーティションに追加している間に実行された場合、分離セマンティクス、再試行の振る舞い、各エンジンが競合を見たときに正確に何をするかを理解する必要がある。
メタデータ増大の計画は何か?
メタデータファイルは小さいが増殖する。日次スナップショットと時間単位のコンパクションを持つテーブルは、月に数千のメタデータファイルを生成するかもしれない。オブジェクトストレージは安いが、LIST操作は無料ではない。一部のクエリエンジンは完全なメタデータツリーをメモリにロードする。ある規模を超えると、メタデータ自体が性能ボトルネックになる。
クエリが誤った結果を返したとき、誰がページされるか?
スナップショット分離は素晴らしい。しかし、カタログが一時的に不整合だったために誰かが誤ったスナップショットを読んだり、ストリーミングジョブが不完全なバッチをコミットしたり、2つのエンジンが同じメタデータファイルを異なるように解釈したりするまでだ。これらの問題をデバッグするには、フォーマット、カタログ、特定のエンジンの専門知識が必要だ。オンコールローテーションはさらに深くなる。
これらの質問に「後で考えよう」より具体的な答えが出せないなら、あなたは技術を採用しているのではない。新しい運用領域を引き受けているのだ。
トレードオフが価値を持つ場所
公平に言おう。オープンテーブルフォーマットが明らかに正しい選択となる状況はある。
ベンダーロックインから積極的に脱出している場合
データウェアハウスプロバイダーが値上げをしたり、機能を廃止したり、出口を制限したりしているなら、オープンフォーマットの移植性は運用オーバーヘッドに見合う。代替案は閉じ込められたままだ。
本当にタイムトラベルとロールバックが必要な場合
規制業界や金融サービスを含む一部のワークロードは、過去の状態を正確に再構成する能力を必要とする。ここではスナップショットモデルはあれば嬉しい程度ではない。コンプライアンス要件だ。
同じデータに対して複数のコンピュートエンジンを実行する場合
アナリティクスチームがSparkを、BIチームがTrinoを、MLパイプラインがDuckDBを使うなら、共有のオープンテーブルフォーマットにより、システム間のETLダンスを排除できる。調整コストは本物だが、同じデータセットの3つの別々のコピーを維持するよりは低い。
そのためのチームがいる場合
メタデータフォーマット、コンパクション戦略、カタログの一貫性モデルを理解するエンジニアがいれば、運用負担は管理可能だ。いなければ、専門知識をコンサルタントにアウトソーシングし、彼らが利用可能であることを祈ることになる。
layline.ioの位置づけ
layline.ioでは、テーブルフォーマットを売っていない。既存のインフラ上でバッチとストリーミングの両方のワークロードを処理する処理ランタイムを売っている。それは理にかなっている場合のオープンテーブルフォーマットも、そうでない場合の従来のストレージも含む。
これが重要な理由:多くのチームがIcebergを採用するのは、バッチとストリーミングを共存させる必要があり、オープンテーブルフォーマットがそれらを統一する唯一の方法だと聞かされているからだ。それは真ではない。統一はストレージ層ではなく処理層で起こる。もしランタイムがバッチモードで構造化の整ったファイルを書き、ストリーミングモードでマイクロバッチを処理し—同じワークフロー内でコンパクション、バックフィル、遅延データを管理できるなら—ストレージフォーマットはアーキテクチャ上のコミットではなく、設定選択になる。
私たちは、正しい理由でIcebergを採用し、その後で難しい部分はフォーマットではなかったことに気づいたチームを見てきた。難しかったのはその周りの運用調整だ:バッチとストリーミングのパスを一貫させ、スキーマ変更を下流のコンシューマーに壊さずに処理し、データがいつ到着しても同じビジネスロジックが同じ結果を生むことを保証すること。
それが私たちが焦点を当てている問題だ。テーブルフォーマットは詳細に過ぎない。運用モデルこそが、火曜日の午前2時にシステムが動作するかどうかを決める。
デモの前に尋ねるべき質問
次にベンダーが洗練されたIcebergのデモを見せてきたら—タイムトラベル、パーティション進化、エンジン切り替えが effortless に見える—こう尋ねよう:
「コンパクションスケジュールを見せてください。カタログのフェイルオーバーを見せてください。ストリーミングジョブとバッチバックフィルが同じパーティションに衝突したときに何が起こるか見せてください。6か月のメタデータ増大後のストレージ料金を見せてください。そして、クエリエンジンが部分的に書き込まれたスナップショットを読んだときに誰がページされるか見せてください。」
答えがドキュメントへの言及なら、あなたは簡単な部分を見ている。難しい部分は今後3年間あなたが所有することになるものだ。
オープンテーブルフォーマットは詐欺ではない。マーケティングがめったに言及しない本物の運用コストを伴う、本物で価値のある技術だ。成功するチームは、そのコストを前もって計算し、最初のテーブルが作られる前に所有者を割り当て、フォーマットをインフラ問題を消す魔法の層ではなく、より大きな運用システムの1つの構成要素として扱うチームだ。
デモは始まりに過ぎない。メンテナンスの請求書こそが、物語が実際に始まる場所だ。
チームがオープンテーブルフォーマットを検討し、総所有コストを把握しようとしている場合は、お問い合わせください。私たちはまさにこの問題でチームと協働しており—何を計画すればいいかわかれば、運用の現実は通常、恐怖ほど管理不能ではありません。
Andrew Tanは、バッチとリアルタイムの両方のワークロードをスケールで処理する企業データ処理インフラを構築するlayline.ioの創設者であり、連続起業家です。